User Group: Wissenschaftler:innen

  • Künstliche Intelligenz kritisch reflektieren

    Künstliche Intelligenz kritisch reflektieren

    Wie wirken intelligente Systeme in der Gesellschaft? Dieser Frage widmet sich das neu gegründete „Interchange Forum for Reflecting on Intelligent Systems“ (IRIS) an der Universität Stuttgart. Mit der Wahl von Jun.-Prof. Maria Wirzberger (Institut für Erziehungswissenschaft) zur Sprecherin und Prof. Steffen Staab (Institut für Parallele und Verteilte Systeme) zum Co-Sprecher nimmt der Forschungsverbund nun seine Arbeit auf.

    Ein strategisches Ziel der Universität ist es, Wissen zu schaffen, damit die Gesellschaft ihre Zukunft verantwortungsvoll gestalten kann. Mit dem Verbund IRIS wollen Forschende gemeinsam die Grundlagen, Mechanismen, Implikationen und Effekte intelligenter Systeme in der Forschung, Lehre und im Hinblick auf die Gesamtgesellschaft kritisch reflektieren. Im Spannungsfeld von KI und Ethik fragen die Wissenschaftlerinnen und Wissenschaftler zum Beispiel, wie man unfaire Diskriminierungen durch den Einsatz von Künstlicher Intelligenz bei automatisierten Entscheidungen oder Stereotype in der Technikentwicklung vermeiden kann.

    Prof. Wolfram Ressel, der Rektor der Universität Stuttgart, kommentiert die Einrichtung erfreut: „Im neuen Forschungsverbund IRIS zeigt die Universität Stuttgart das, was sie besonders gut kann: ein hochaktuelles Thema aus unterschiedlichsten Blickwinkeln und über Fächergrenzen hinweg zu diskutieren und zu erforschen. IRIS führt Wissenschaftlerinnen und Wissenschaftler aus allen Disziplinen der Universität zusammen – die KI-Forscherin und den Philosophen, den Sprachwissenschaftler und die Software-Ingenieurin – um gemeinsam intelligente Systeme verantwortlich und zukunftsfähig zu gestalten. Unser Ziel ist es, mit dieser in IRIS gebündelten Kompetenz eine Führungsposition in der Reflexion intelligenter Systeme einzunehmen.“

    Jun.-Prof. Maria Wirzberger, die Sprecherin des neuen Forschungsschwerpunkts IRIS, und ihr Team beschäftigt unter anderem die Frage, wie Diskriminierung durch Technik entsteht und wie man dem entgegenwirken kann. Sie sagt: „Vereinfacht gesagt funktionieren Algorithmen wie Schubladen. funktionieren Algorithmen wie Schubladen. Sie beruhen auf Standards, die von Menschen gesetzt werden und darum auch mit deren Stereotypen behaftet sein können. Diese Stereotype sind oft unbewusst und fließen damit unreflektiert in die Technikentwicklung ein.“ Co-Sprecher Prof. Steffen Staab arbeitet mit seinem Team interdisziplinär daran, technische Entscheidungsfindung, wie Darlehensbewilligung durch Künstliche Intelligenz, ganzheitlich zu verstehen. „Wir haben in den letzten Jahren gelernt, wie der naive Einsatz von Künstlicher Intelligenz für automatisierte Entscheidungen zu unfairer Diskriminierung führen kann. Aus diesem Grund entwickeln wir neue Methoden zur Vermeidung, Erkennung und Erklärung von Un-/ Fairness“, sagt er.

    Weitere Aufgaben und Angebote von IRIS

    Neben der Forschung schafft IRIS Austauschmöglichkeiten, um inner- und außerhalb der Universität mit Partnern aus Gesellschaft und Wirtschaft über aktuelle ethische und gesellschaftliche Herausforderungen intelligenter Systeme zu diskutieren, angefangen von Datenethik über informationelle Selbstbestimmung bis zu vertrauenswürdiger KI. Und auch die Lehre steht im Fokus: Das Lehrforum Reflecting on Intelligent Systems in the Next Generation (RISING) unter der Leitung von Wirzberger vermittelt Studierenden aller Fächer die kritische Reflektion intelligenter Systeme.

    Für einen verantwortungsvollen Umgang mit intelligenten Systemen

    Wie hilft IRIS, etwas gegen Stereotype in der Technikentwicklung zu tun? Sprecherin Wirzberger erklärt: „Der Nutzen ist, dass Studierende, wenn sie in den Beruf gehen, für dieses Thema sensibilisiert sind. Dann passieren solche Dinge wie diskriminierende Technik nicht mehr in diesem Ausmaß.“ Zum anderen soll die internationale Vernetzung der Universität gestärkt werden. Wenn unterschiedliche Menschen zusammenkommen, entständen gute Ideen und es gäbe einen lebhaften Austausch, meint die Wissenschaftlerin. Am neuen universitätsweiten Forschungsverbund IRIS sind Wissenschaftlerinnen und Wissenschaftler aus den Exzellenzclustern sowie aus allen Profil- und Potenzialbereichen der Universität beteiligt. Gefördert wird IRIS durch die Deutsche Forschungsgemeinschaft (DFG) im Rahmen der Exzellenzstrategie des Bundes und der Länder sowie durch den Forschungsfonds der Universität.
  • Künstliche Intelligenz unterstützt medizinische Prognosen

    Künstliche Intelligenz unterstützt medizinische Prognosen

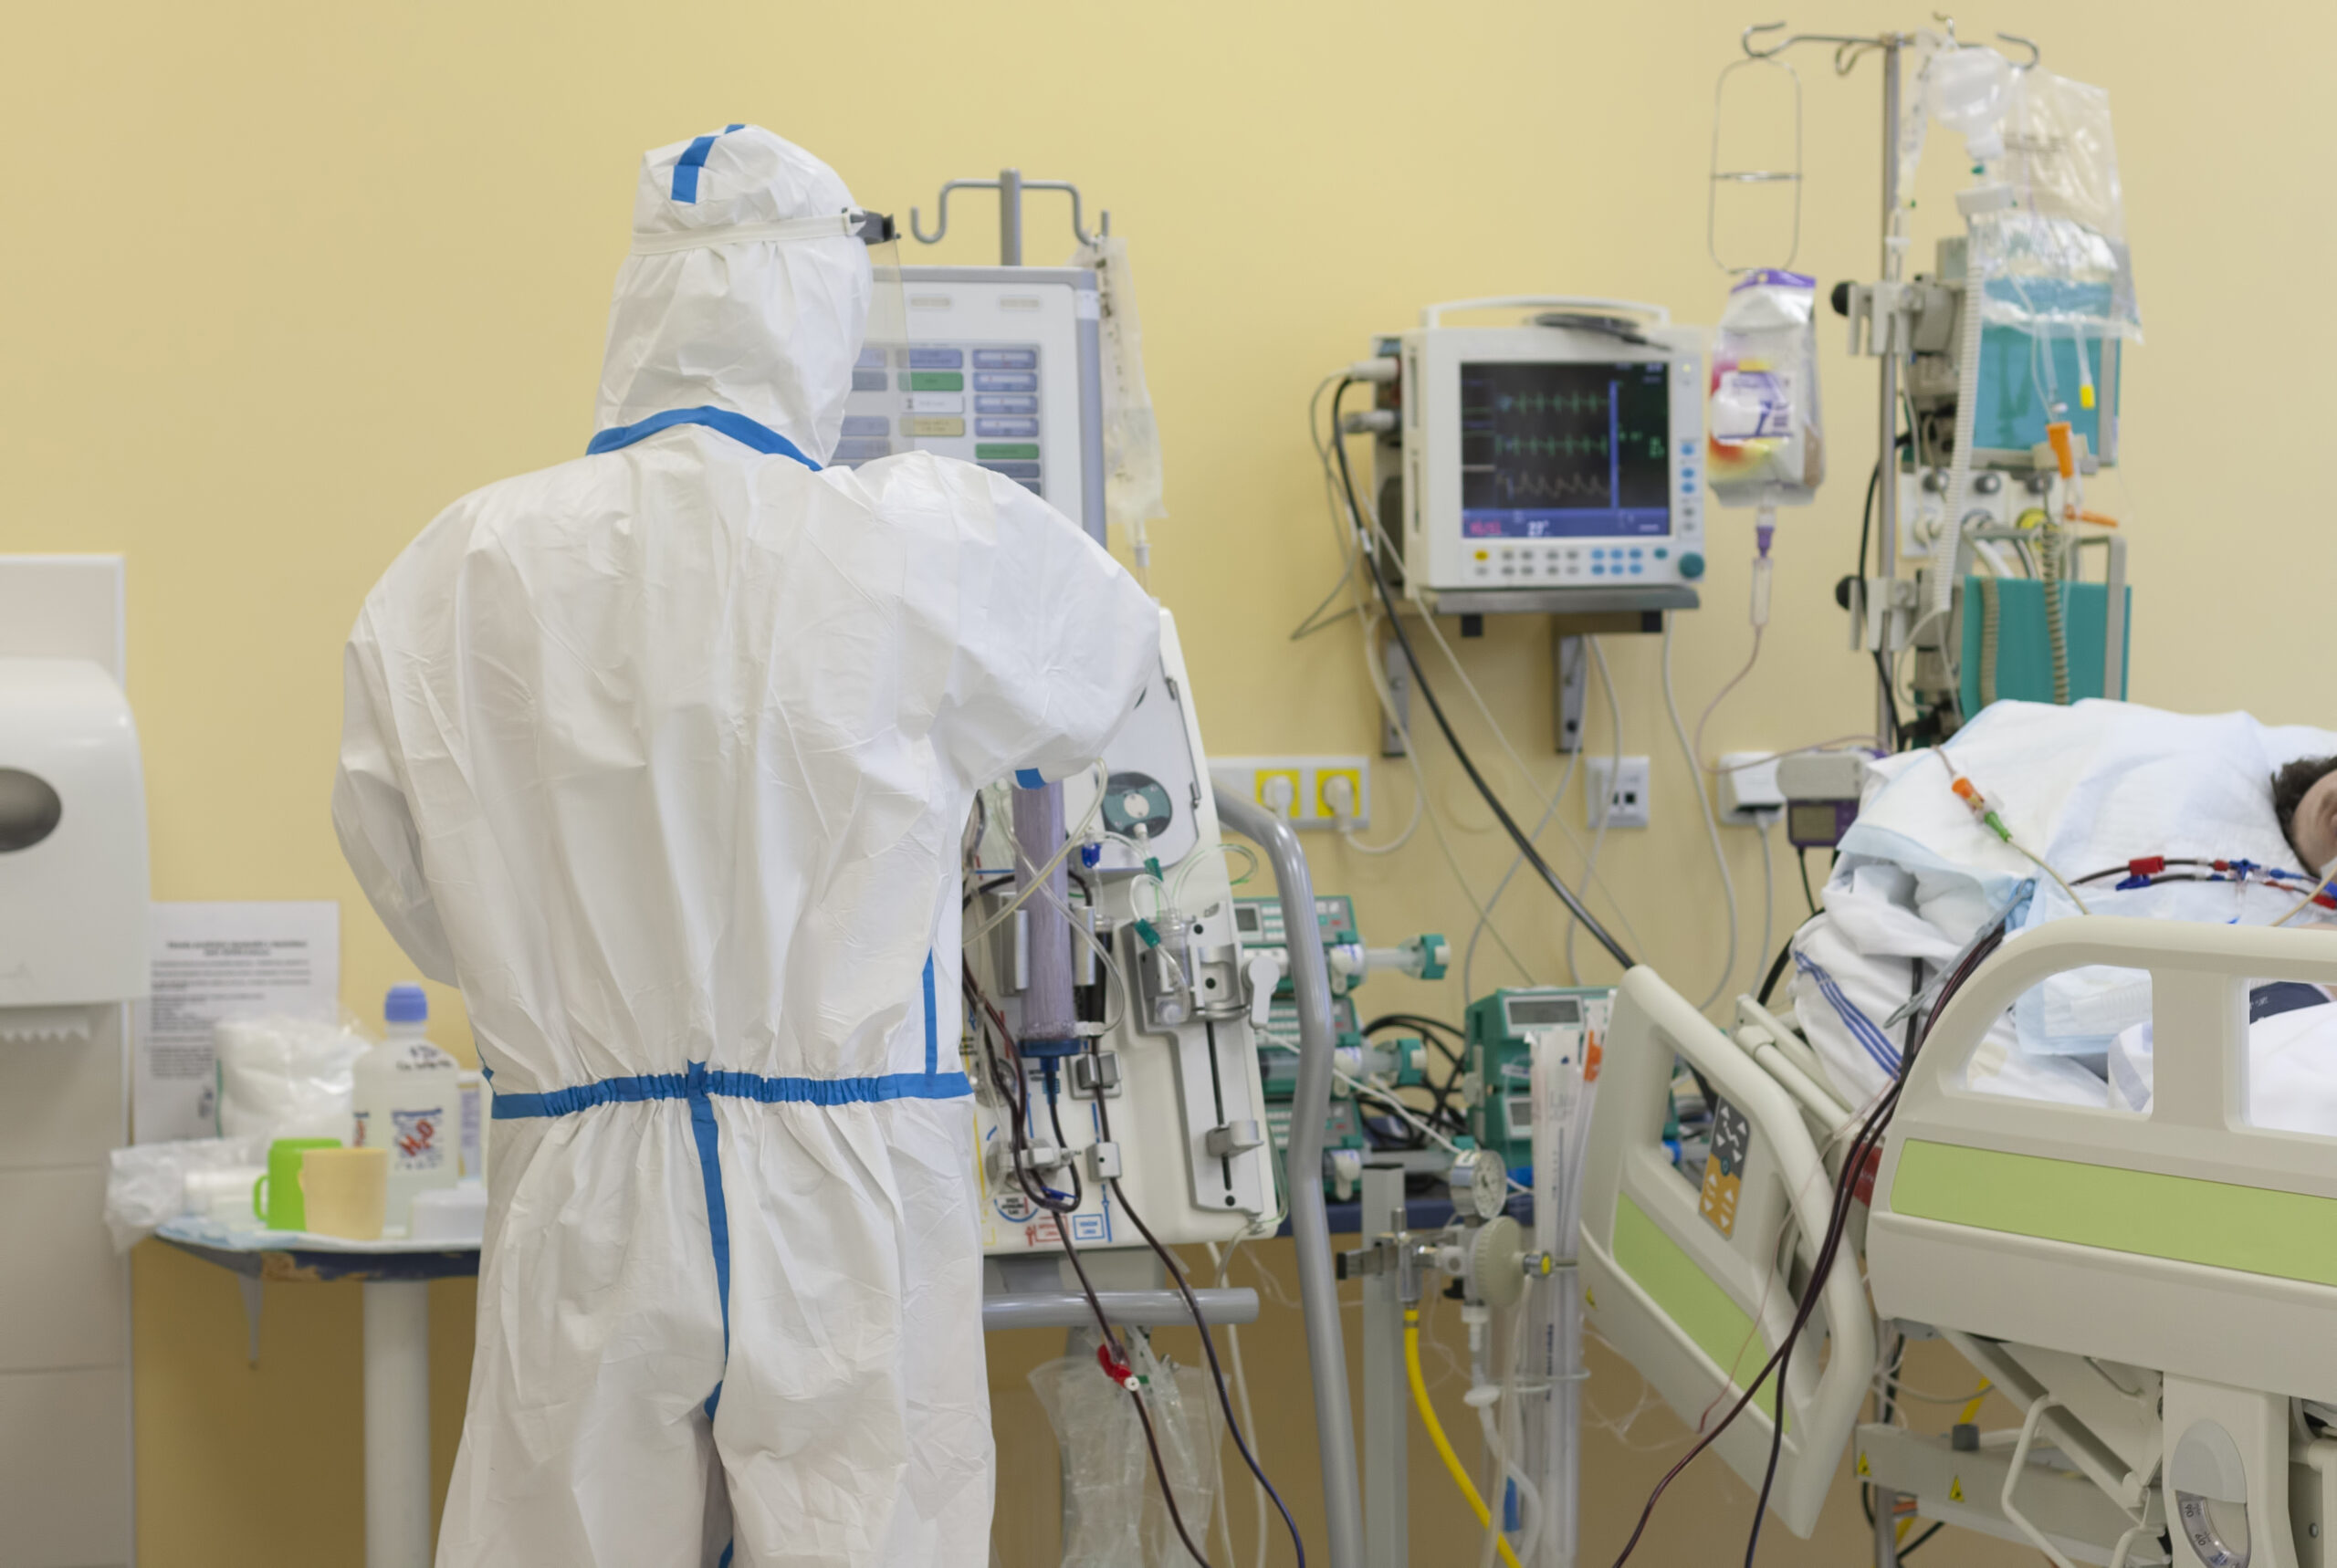
    Für Ärztinnen und Ärzte sind es die wohl schwierigsten und belastendsten Entscheidungen: Gerade in der Covid-19-Pandemie müssen sie immer wieder abschätzen, wie hoch das Risiko für Patienten ist, an der Erkrankung zu sterben. Im besten Fall können sie dann die Behandlung anpassen, um die Betroffenen zu retten. Im schlimmsten Fall müssen sie knappe Ressourcen wie Intensivbetten oder lebensrettende Maschinen verteilen. Ein Team um Forschende des Max-Planck-Instituts für Intelligente Systeme hat nun einen Algorithmus entwickelt und mit Methoden des maschinellen Lernens trainiert, um Medizinerinnen und Mediziner mit Vorhersagen der Sterblichkeit zu unterstützen. Der Algorithmus lässt sich auch nutzen, um das Sterblichkeitsrisiko bei anderen Erkrankungen vorherzusagen.

    Tübingen, den 16.02.2021 – In Krankenhäusern erheben Ärztinnen und Ärzte eine Fülle von medizinischen Daten, doch ob eine Krankheit bei einem Patienten zum Tod führt, können auch Fachleute daraus in vielen Fällen erst ablesen, wenn es für eine Rettung zu spät ist. Bei Covid-19 etwa sind hohes Alter und Vorerkrankungen relevante Risikofaktoren für eine ernsthafte Erkrankung. Es sind aber längst nicht die einzigen. Auch die Sauerstoffsättigung, die Zahl der weißen Blutkörperchen oder der Kreatinin-Wert gehören dazu. „Aber selbst erfahrene Mediziner können in diesen Parametern nicht früh genug eindeutige Muster für einen tödlichen Verlauf erkennen, um eventuell noch die Therapie anzupassen“, sagt Stefan Bauer, Leiter einer Forschungsgruppe am Max-Planck-Institut für Intelligente Systeme in Tübingen.

    Genau da kann künstliche Intelligenz, genauer gesagt maschinelles Lernen hilfreich sein. Diese Methode lernt anhand von vielen Beispielen, Muster in Daten zu erkennen. Deshalb hat ein internationales Team um Stefan Bauer vom Max-Planck-Institut für Intelligente Systeme und Patrick Schwab, ein ehemaliger Mitarbeiter von Roche, einen Algorithmus entwickelt und mit Daten zu Krankheitsverläufen von Tausenden Covid-19-Patientinnen und -Patienten darauf trainiert, die individuelle Sterblichkeit für die Erkrankung vorherzusagen. Den Algorithmus nennen sie Covews, kurz für Covid-19 Early Warning System. Neben Wissenschaftlern des Tübinger Max-Planck-Instituts und von Roche, waren auch Forschende der Harvard-Universität und der Harvard Medical School sowie des Massachusetts Institute of Technology, der Universitätsklinik Tübingen und des Kantonsspitals Winterthur an der Arbeit beteiligt. Ihre Publikation „Real-time prediction of COVID-19 related mortality using electronic health records” erschien heute in Nature Communications.

    Vorhersagen mit 95 prozentiger Sensitivität und knapp 70 prozentiger Spezifität

    Covews liest aus den medizinischen Daten bis zu acht Tage im Vorhinein, wenn ein Patient zu sterben droht, und zwar mit einer Sensitivität von mehr als 95 Prozent. Das heißt, der Algorithmus erkennt bei 95 von 100 Menschen, dass sie sterben werden, wenn nicht Maßnahmen getroffen werden, um das zu verhindern. Gleichzeitig arbeitet Covews bei einer Vorhersage acht Tage im Voraus mit einer Spezifität von knapp 70 Prozent. Das bedeutet, etwa 70 von 100 Menschen, bei denen ein tödlicher Verlauf prognostiziert wird, sterben auch tatsächlich. In rund 30 Fällen gibt der Algorithmus also falschen Alarm. Der Algorithmus lässt sich auch darauf trainieren weniger sensitive, aber spezifischere Prognosen zu erstellen. „Aber es ist wichtiger, möglichst alle Menschen mit hohem Sterblichkeitsrisiko zu erfassen, als bei einigen fälschlicherweise ein hohes Risiko zu prognostizieren“, sagt Stefan Bauer. Möglicherweise werden dann bei mehr Menschen als nötig besondere Therapiemaßnahmen ergriffen, um einen vermeintlichen Tod abzuwenden.

    Für die Entwicklung, vor allem das Training von Covews nutzten die Forschenden 33.000 anonymisierte Datensätze aus einer Kohorte namens Optum, die Patientinnen und Patienten in verschiedenen Krankenhäusern der USA erfasst. Sie fütterten den Algorithmus also mit Information darüber, wie sich routinemäßig erhobene Gesundheitsparameter einer Patientin oder eines Patienten im Krankheitsverlauf entwickelten und ob die Person an Covid-19 starben oder nicht. Auf diese Weise lernte Covews, in den Datensätzen Muster zu erkennen, die auf ein hohes Sterblichkeitsrisiko hinweisen. Wie treffsicher Covews dieses Risiko einschätzt, testete das internationale Team anschließend an etwa 14.000 weiteren Datensätzen aus der Optum-Kohorte. „Unser Algorithmus prognostiziert das Sterblichkeitsrisiko aber nicht nur mit Datensätzen aus dieser Kohorte mit hoher Sicherheit, sondern auch mit Daten aus anderen Krankenhäusern, die nicht genau der gleichen Verteilung folgen“, sagt Stefan Bauer. Das zeigten die Forschenden, indem sie Covews an Daten des globalen Gesundheitsnetzwerks TriNetX erprobten, das etwa 5.000 US-amerikanische, australische, indische und malayische Patientinnen und Patienten mit einem positiven Coronatest enthält. Auch bei diesen Testfällen aus Krankenhäusern in unterschiedlichen Weltregionen sagte Covews das Sterblichkeitsrisiko sehr sensitiv und spezifisch voraus.

    Entscheidungen über Therapien müssen immer Ärzte treffen

    Obwohl Covews zuverlässige Vorhersagen trifft, dürfte es bis zu seinem praktischen Einsatz noch eine Weile dauern. „Bis solche neuen Techniken im Klinikalltag angewendet werden, vergehen oftmals mehrere Jahre“, sagt Stefan Bauer. Das liegt unter anderem daran, dass Daten vielen Krankenhäusern nicht strukturiert vorliegen, was die Entwicklung einer geeigneten Software auf Basis des Algorithmus besonders herausfordernd macht. Indem die Forschenden Covews frei zugänglich ins Netz stellen, schaffen sie jedenfalls die Voraussetzungen, den Algorithmus zügig in die Praxis zu bringen. Und Anwendung könnte er nicht nur bei Covid-19-Patienten finden. Mit dem entsprechenden Training könnte er auch das Sterblichkeitsrisiko für andere Erkrankungen vorhersagen.

    Wie die meisten Vorhersagen mit Methoden des maschinellen Lernens werden die Prognosen von Covews nicht aus Kausalzusammenhängen, sondern aus Korrelationen abgeleitet. Bei Korrelationen kann es sich um einen rein statistischen, also nicht ursächlichen Zusammenhang handeln. Sein Team weist zudem auf eine Einschränkung der Covews-Berechnungen hin: Möglicherweise sagt der Algorithmus nicht die Sterblichkeit, sondern den Abbruch der Behandlung voraus. Dann würden die Prognosen nicht nur auf medizinischen Fakten beruhen. „Bei der Entscheidung, eine Therapie einzustellen, spielen nicht nur medizinische Überlegungen eine Rolle“, sagt Stefan Bauer. Auch religiöse, kulturelle oder persönliche Haltungen können Menschen dazu bringen, sich nicht weiter behandeln zu lassen. So können Menschen generell eine künstliche Beatmung ablehnen oder aus Furcht vor den Langzeitfolgen einer Erkrankung die Rettung ihres Lebens ablehnen. Und oft genug sind es Familienangehörige oder Freunde, die bei solchen Entscheidungen mitsprechen. „Über Therapiemaßnahmen müssen daher immer Ärztinnen oder Ärzte entscheiden“, sagt Stefan Bauer. „Unser Algorithmus kann jedoch Erkenntnisse liefern, die Menschen aus den Daten nicht ableiten können, und die bei medizinischen Entscheidungen helfen können.“

  • In den Fängen der Bequemlichkeit: KI unter der Lupe

    In den Fängen der Bequemlichkeit: KI unter der Lupe

    Die Errungenschaften von künstlicher Intelligenz (KI) werden meist als Erfolgsgeschichten betrachtet: KI übersetzt Texte mit einer beeindruckenden Treffsicherheit, erkennt Krebs teilweise besser als Ärztinnen und Ärzte. Dabei gerät oftmals in den Hintergrund, dass KI auch Fehler macht. In welchen verschiedenen Formen diese in Erscheinung treten, hat ein internationales Team von Wissenschaftlern in einem Perspektiven-Papier zusammengetragen. Darin richten sie ihren Fokus darauf, wie KI lernt und wie es passieren kann, dass hierbei etwas schiefgeht, obwohl die Algorithmen bei üblichen Testverfahren gut abschneiden.

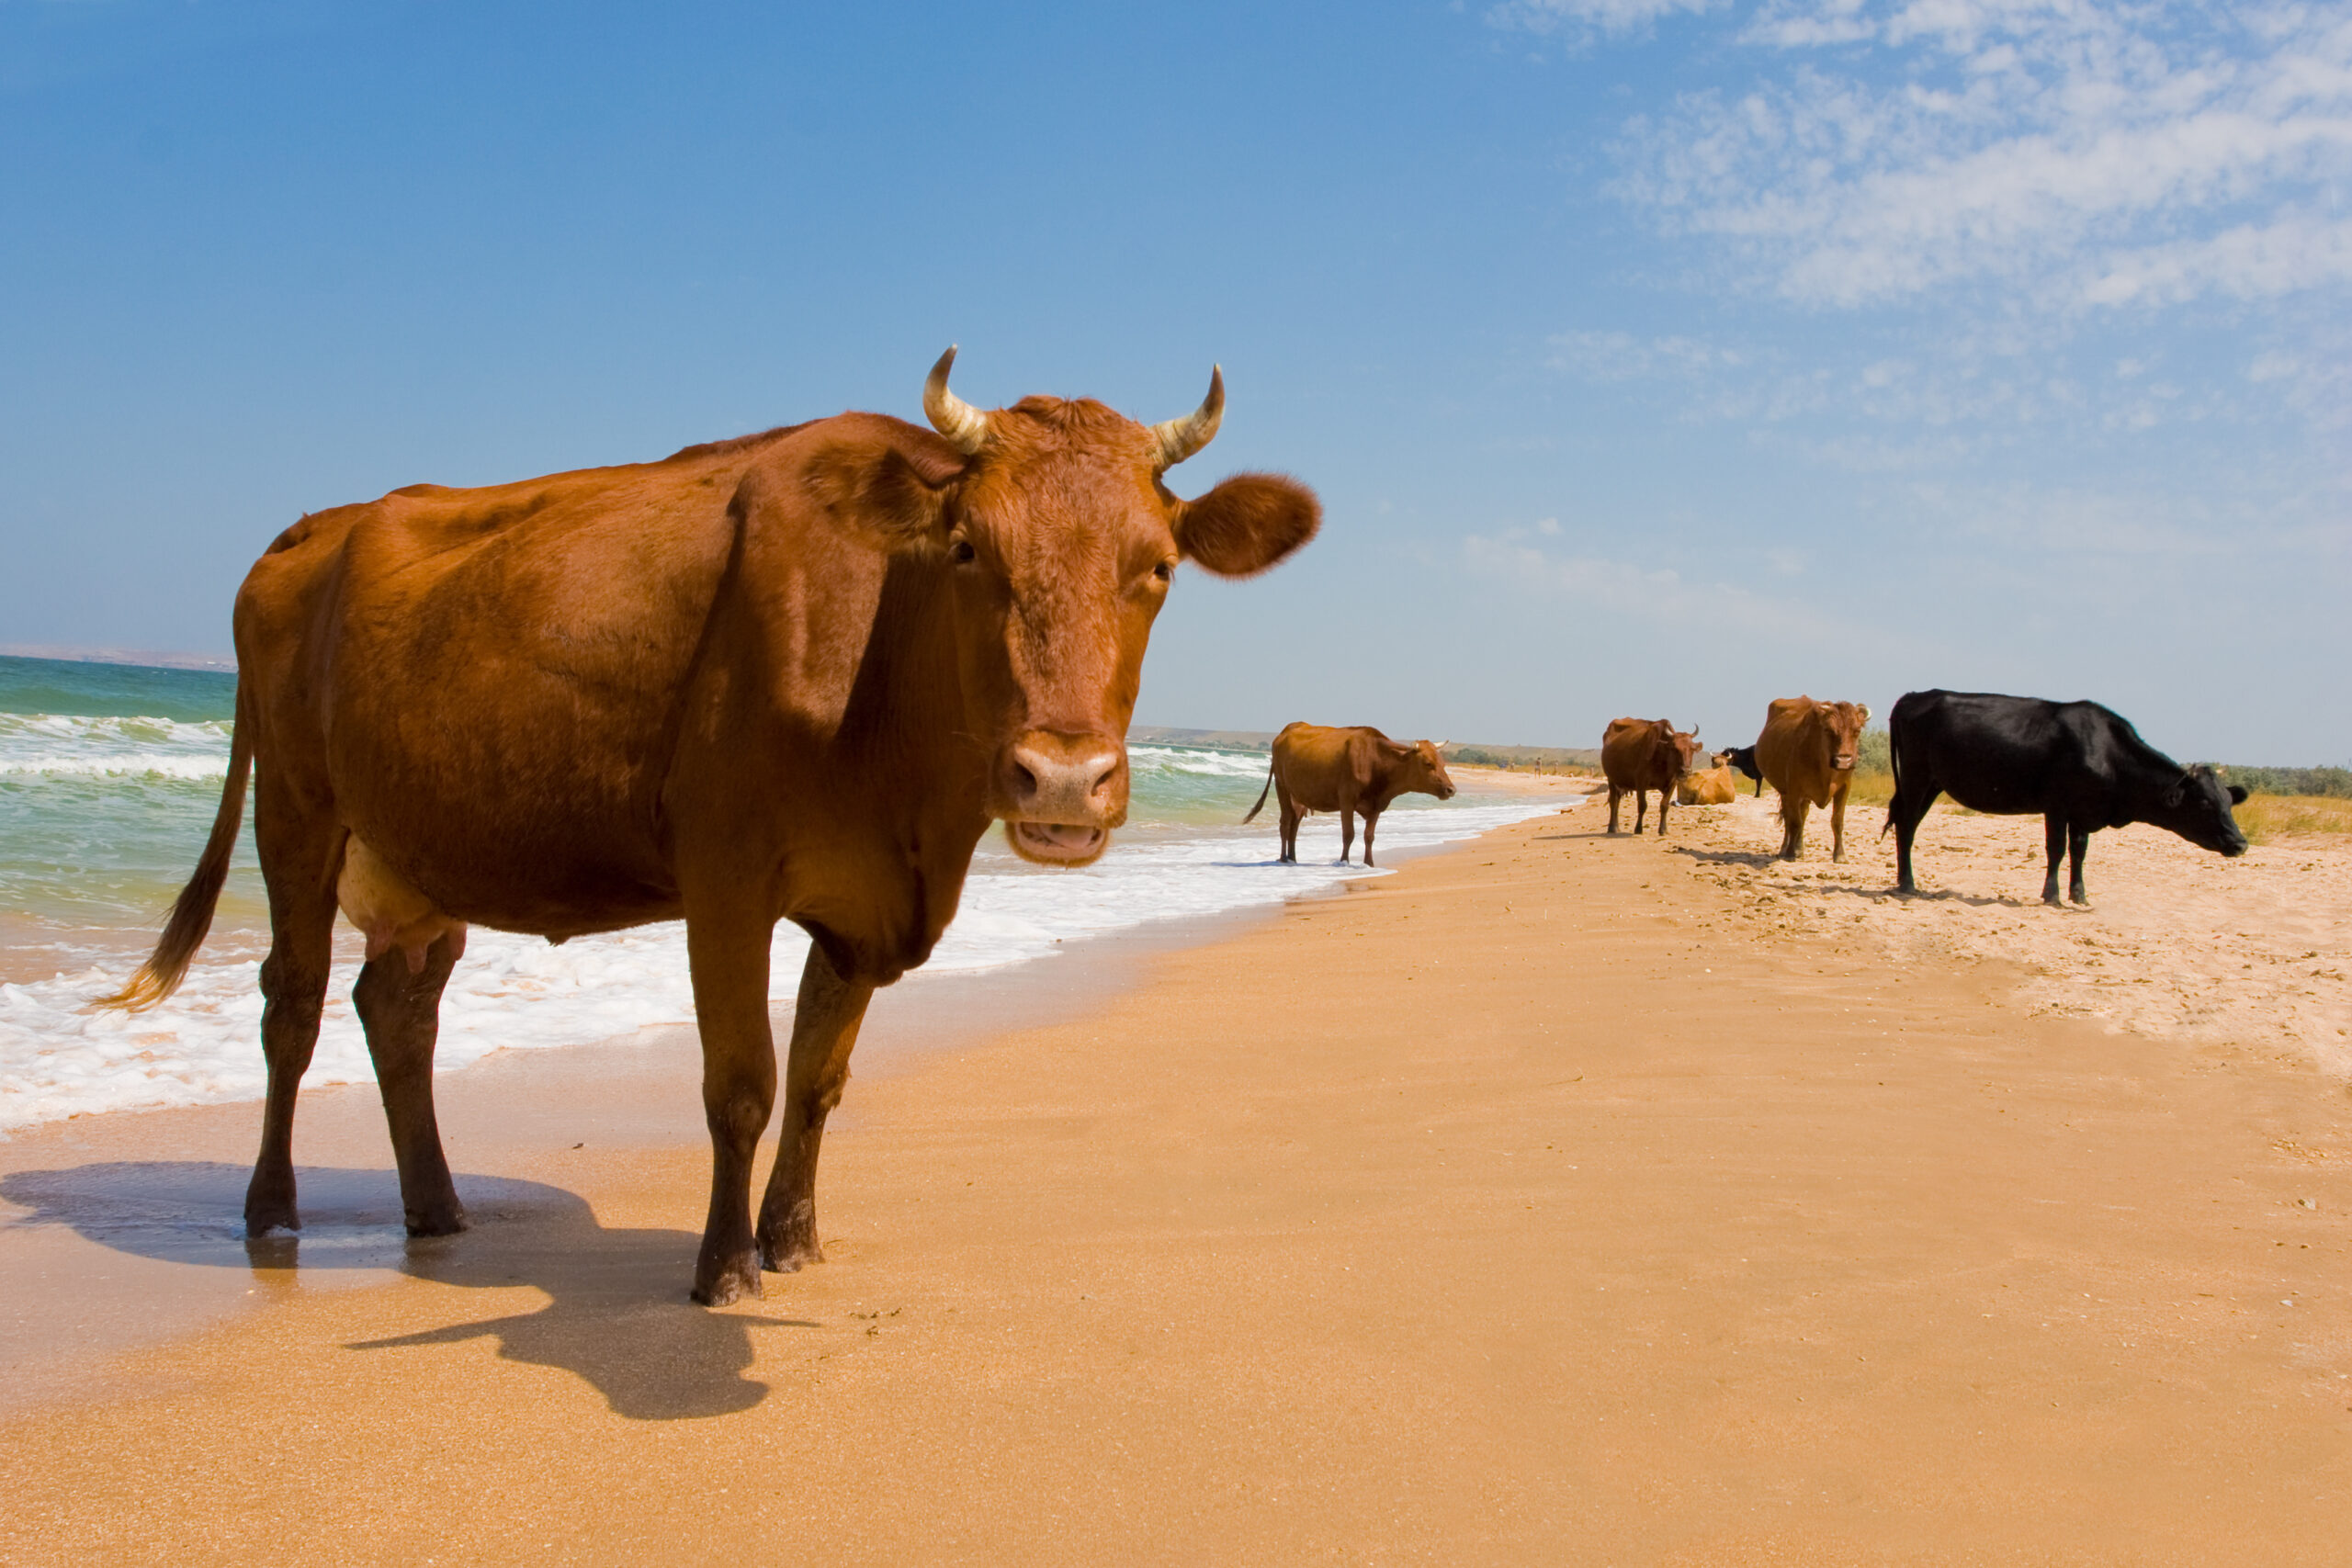
    Das interdisziplinäre Team aus Wissenschaftlern der Universität Tübingen (Robert Geirhos, Claudio Michaelis, Wieland Brendel, Matthias Bethge, Felix Wichmann) und der Universität Toronto, Kanada (Jörn-Henrik Jacobsen, Richard Zemel) beobachtete, dass viele Fehler von KI sozusagen heimlich entstehen und zunächst unbemerkt bleiben. Beispielsweise scheint eine KI auf den ersten Blick hervorragend zu erkennen, welche Tiere sich auf einem Foto befinden. Erst bei genauerem Hinsehen stellt sich heraus, dass die KI eine deutlich bequemere Strategie gefunden hat und manchmal einfach nur auf den Hintergrund achtet: So wird eine leere grüne Hügellandschaft von der KI kurzerhand als „Herde grasender Tiere“ bezeichnet – denn oft stehen Tiere vor grünem Hintergrund –, während eine Kuh vor einem unüblichen Hintergrund, beispielsweise am Strand, dagegen nicht erkannt wird. Was zunächst wie ein lustiger Fehler wirkt, kann durchaus ernste Konsequenzen nach sich ziehen. Denn ähnliche KI-Verfahren werden beispielsweise auch in Autos mit modernen Fahrassistenz-Systemen zur Erkennung von Fußgängern eingesetzt und in der Medizin bei der Früherkennung von Krebserkrankungen getestet.

    Dieses „Shortcut Learning“ ist kein Phänomen, das nur bei KI-Systemen vorkommt, im Gegenteil. Derartige Abkürzungen beim Lernen sind ebenfalls in der Natur zu beobachten, auch bei Menschen. Ein Beispiel: Wenn Schülerinnen und Schüler im Geschichtsunterricht lediglich Jahreszahlen auswendig lernen, ohne ein tieferes Verständnis für historische Zusammenhänge zu entwickeln, nur um die spezifischen Anforderungen einer Klassenarbeit zu erfüllen. Oder ein Beispiel aus der Tierwelt: Bei einem Experiment, in dem Ratten durch ein Labyrinth mit unterschiedlich gefärbten Wänden zum Ziel finden mussten, waren die Tiere schnell zielsicher unterwegs. Verblüffenderweise fanden sie sich viel besser zurecht, als es die Versuchsleiter erwartet hatten. Die Fähigkeit, Farben optisch unterscheiden zu können, ist bei dieser Rattengattung nämlich nicht besonders ausgeprägt. Erst nach einer genauen Überprüfung der Testergebnisse wurde klar, dass die Tiere nicht mit ihren Augen durchs Labyrinth fanden. Sie hatten stattdessen dank ihres ausgeprägten Geruchssinns die richtige Route erlernt, denn die verschiedenen Wandfarben rochen unterschiedlich.

    Analog dazu suchen sich auch KI-Systeme oftmals irgendeinen Weg zum Ziel, der sich für das System gerade am meisten anbietet. Das mag bei Bildern von Kühen in unterschiedlichen Landschaften nicht weiter tragisch sein. Dieses Verhalten wird aber dann problematisch, wenn etwa Banken bei der Kreditvergabe Algorithmen einsetzen. So kann es in den USA vorkommen, dass über die Postleitzahl des Antragstellers auf das soziale Milieu geschlossen wird – und damit auch über die Wahrscheinlichkeit der Rückzahlung, also die Kreditwürdigkeit. Die Abkürzung in diesem Fall: Über die Angabe der Postleitzahl gewinnt eine Korrelation an entscheidender Bedeutung. Ob es aber einen kausalen Zusammenhang zwischen der Postleitzahl und der tatsächlichen Kreditwürdigkeit des Bankkunden gibt, kann der Algorithmus nicht ermitteln.

    In ihrem Aufsatz, einem „Perspective Article“, der in der Fachzeitschrift „Nature Machine Intelligence“ veröffentlicht wurde, beschreiben die Wissenschaftler das gemeinsame Muster hinter vielen dieser von anderen Forschenden berichteten Anekdoten. Sie fordern, dass KI in Zukunft stärker unter die Lupe genommen wird. Gute Testnoten von KI-Lernverfahren in den gängigen Testverfahren sind nicht ausreichend, um eine gute Alltagstauglichkeit zu garantieren. Konkret regen die Autoren an, in der KI-Forschung stärkere Testverfahren zu entwickeln und anzuwenden. „Die gängigen Standard-Testverfahren sind zu schwach, denn dadurch werden die Algorithmen häufig nur auf ähnlichen Daten getestet“, sagt Robert Geirhos, Doktorand an der Universität Tübingen und Erstautor der Arbeit. „Wir plädieren deshalb dafür, dass KI-Systeme mit deutlich schwereren Datensätzen getestet werden, in denen Unerwartetes abgefragt wird und ihnen so Transferleistungen abverlangt werden.“

    Denn solange man nicht untersucht hat, ob ein Algorithmus mit unerwarteten Bildern, wie beispielsweise einer Kuh am Strand, problemlos zurechtkommt, muss man zumindest in Betracht ziehen, dass das KI-System auf dem Weg zur Antwort eine Abkürzung genommen hat. „Zum Glück ist das ,Abkürzen’ für einen Algorithmus aber nicht die einzige Option, sondern nur die bequemste“, betont Geirhos. „Wenn man KI entsprechend herausfordert, kann sie durchaus hochkomplexe Zusammenhänge erlernen.“

  • Bosch AI Con 2021

    Bosch AI Con 2021

    What is the AI CON 2021 about?

    Industrial AI or how to bring AI to the real world: A topic that not only Bosch is affected by. Learn about the Bosch way in this field through an exciting Keynote of Bosch’s CTO Michael Bolle on the AIoT Cycle and on the importance of Hybrid Models. You will also get insights into how other industrial companies handle this exciting field. But there is even more! You will have the chance to learn from renown researchers and AI experts from the industry sector like Raquel Urtasun (Uber ATG), Zico Kolter (Carnegie Mellon University), Jun Zhu (Tsinghua University), Nuria Oliver (MIT) or George Em Karniadakis (Brown University) about the latest findings and hot topics in the field of AI.

    Listen to exciting keynotes about various AI hot topics

    Experience what is possible through AI at our virtual exhibition

    Meet in instructive technical deep dives our AI experts and renowned researchers from the AI Community on innovative and hot topics

    Exchange with like-minded people to get new impulses and enable future collaborations

    From 13:00 – 17:00 Cyber Valley representatives will be available for virtual coffee breaks during BOSCH AI Con. If you’re interested in finding out about research and founding opportunities in Europe’s largest ecosystem for research and innovation in modern AI, please feel free to join for one of these 20-minute sessions. Our representatives will be talking about their experiences and answering questions about life as a researcher or entrepreneur in Cyber Valley.


    Be excited about what awaits you at the 2021 virtual AI CON!

  • Cyber Valley Professor punktet bei Ranking der Wirtschaftswoche

    Cyber Valley Professor punktet bei Ranking der Wirtschaftswoche

    Prof. Alexander Brem vom Institut für Entrepreneurship und Innovationsforschung der Universität Stuttgart platzierte sich bei einem Ranking der Wirtschaftswoche im Autorenranking unter den Top 20 Forschenden der BWL in Deutschland, Österreich und der Schweiz. Er gehört damit im DACH-Raum zu den Top 0,5 Prozent aller Wirtschaftswissenschaftlerinnen und -wissenschaftler sämtlicher Fachbereiche, wie Management, Finance, Steuern, Produktion, Marketing, Personal und Entrepreneurship. Im Lebenswerkranking belegt er den Platz 153.

    Das Ranking der aktuellen Forschungsleistung umfasst die Publikationen im Fünfjahreszeitraum 2016 bis einschließlich 2020 (Stichtag 1. August). Die Lebenswerkwertung berücksichtigt alle jemals publizierten Artikel eines Forschenden, das Ranking der „Jungen Wilden“ alle Publikationen von Forschenden, die am Stichtag noch keine 40 Jahre alt waren.

    Die Ranglisten erfassen die Publikationen von Betriebswirtinnen und Betriebswirten, die in Deutschland, Österreich und der Schweiz an Lehrstühlen, Fraunhofer- und Max- Planck-Instituten arbeiten (inklusive Post-Docs und Juniorprofessoren). Das Autorenranking erfasste 3.346 Personen, das U40 Ranking 481 Wissenschaftler, und die Wertung für das Lebenswerk 4.051 Forschende.

    Datenquelle ist das bibliometrische Webportal Forschungsmonitoring, das vom Wirtschaftsforschungsinstitut KOF der ETH Zürich mit Unterstützung des Düsseldorf Institute for Competition Economics betrieben wird. Berücksichtigt wurden Publikationen in knapp 860 BWL-Zeitschriften, die nach ihrer Reputation gewichtet wurden.

  • Virtuelles S-TEC Spitzentreffen 2021

    Virtuelles S-TEC Spitzentreffen 2021

    Die Stuttgarter Fraunhofer-Institute IAO und IPA laden herzlich zum virtuellen S-TEC Spitzentreffen am 25. Februar 2021 ein, um gemeinsam mit Ihnen und Baden-Württembergs Wirtschaftsministerin Dr. Nicole Hoffmeister-Kraut einen Blick auf die laufenden Entwicklungen und Forschungserkenntnisse zum Thema KI und Robotik zu werfen. Ein besonderer Fokus liegt hierbei auf dem KI-Fortschrittszentrum »Lernende Systeme« und dem Zentrum für Cyber Cognitive Intelligence (CCI) der Stuttgarter Fraunhofer-Institute IAO und IPA. Das KI-Fortschrittszentrum »Lernende Systeme« schließt durch Technologietransfer die Lücke zwischen KI-Spitzenforschung und der breiten Anwendung in der produzierenden Industrie.

    Neben dem Grußwort der Ministerin bietet Ihnen die Veranstaltung einen umfassenden Einblick in die Erfahrungsberichte konkreter KI-Praxisbeispiele kooperierender Unternehmen aus der Region. Freuen Sie sich zudem auf Keynotes, Pitches und eine Podiumsdiskussion, in der Sie Ihre Erfahrungen, Ideen und Fragen mit den KI-Expertinnen und Experten teilen dürfen.

  • Fortschritte auf dem Gebiet der Brain-Computer-Interaktion (BCI): Forschende holen die BCI-Forschung aus dem Labor in die reale Welt

    Fortschritte auf dem Gebiet der Brain-Computer-Interaktion (BCI): Forschende holen die BCI-Forschung aus dem Labor in die reale Welt

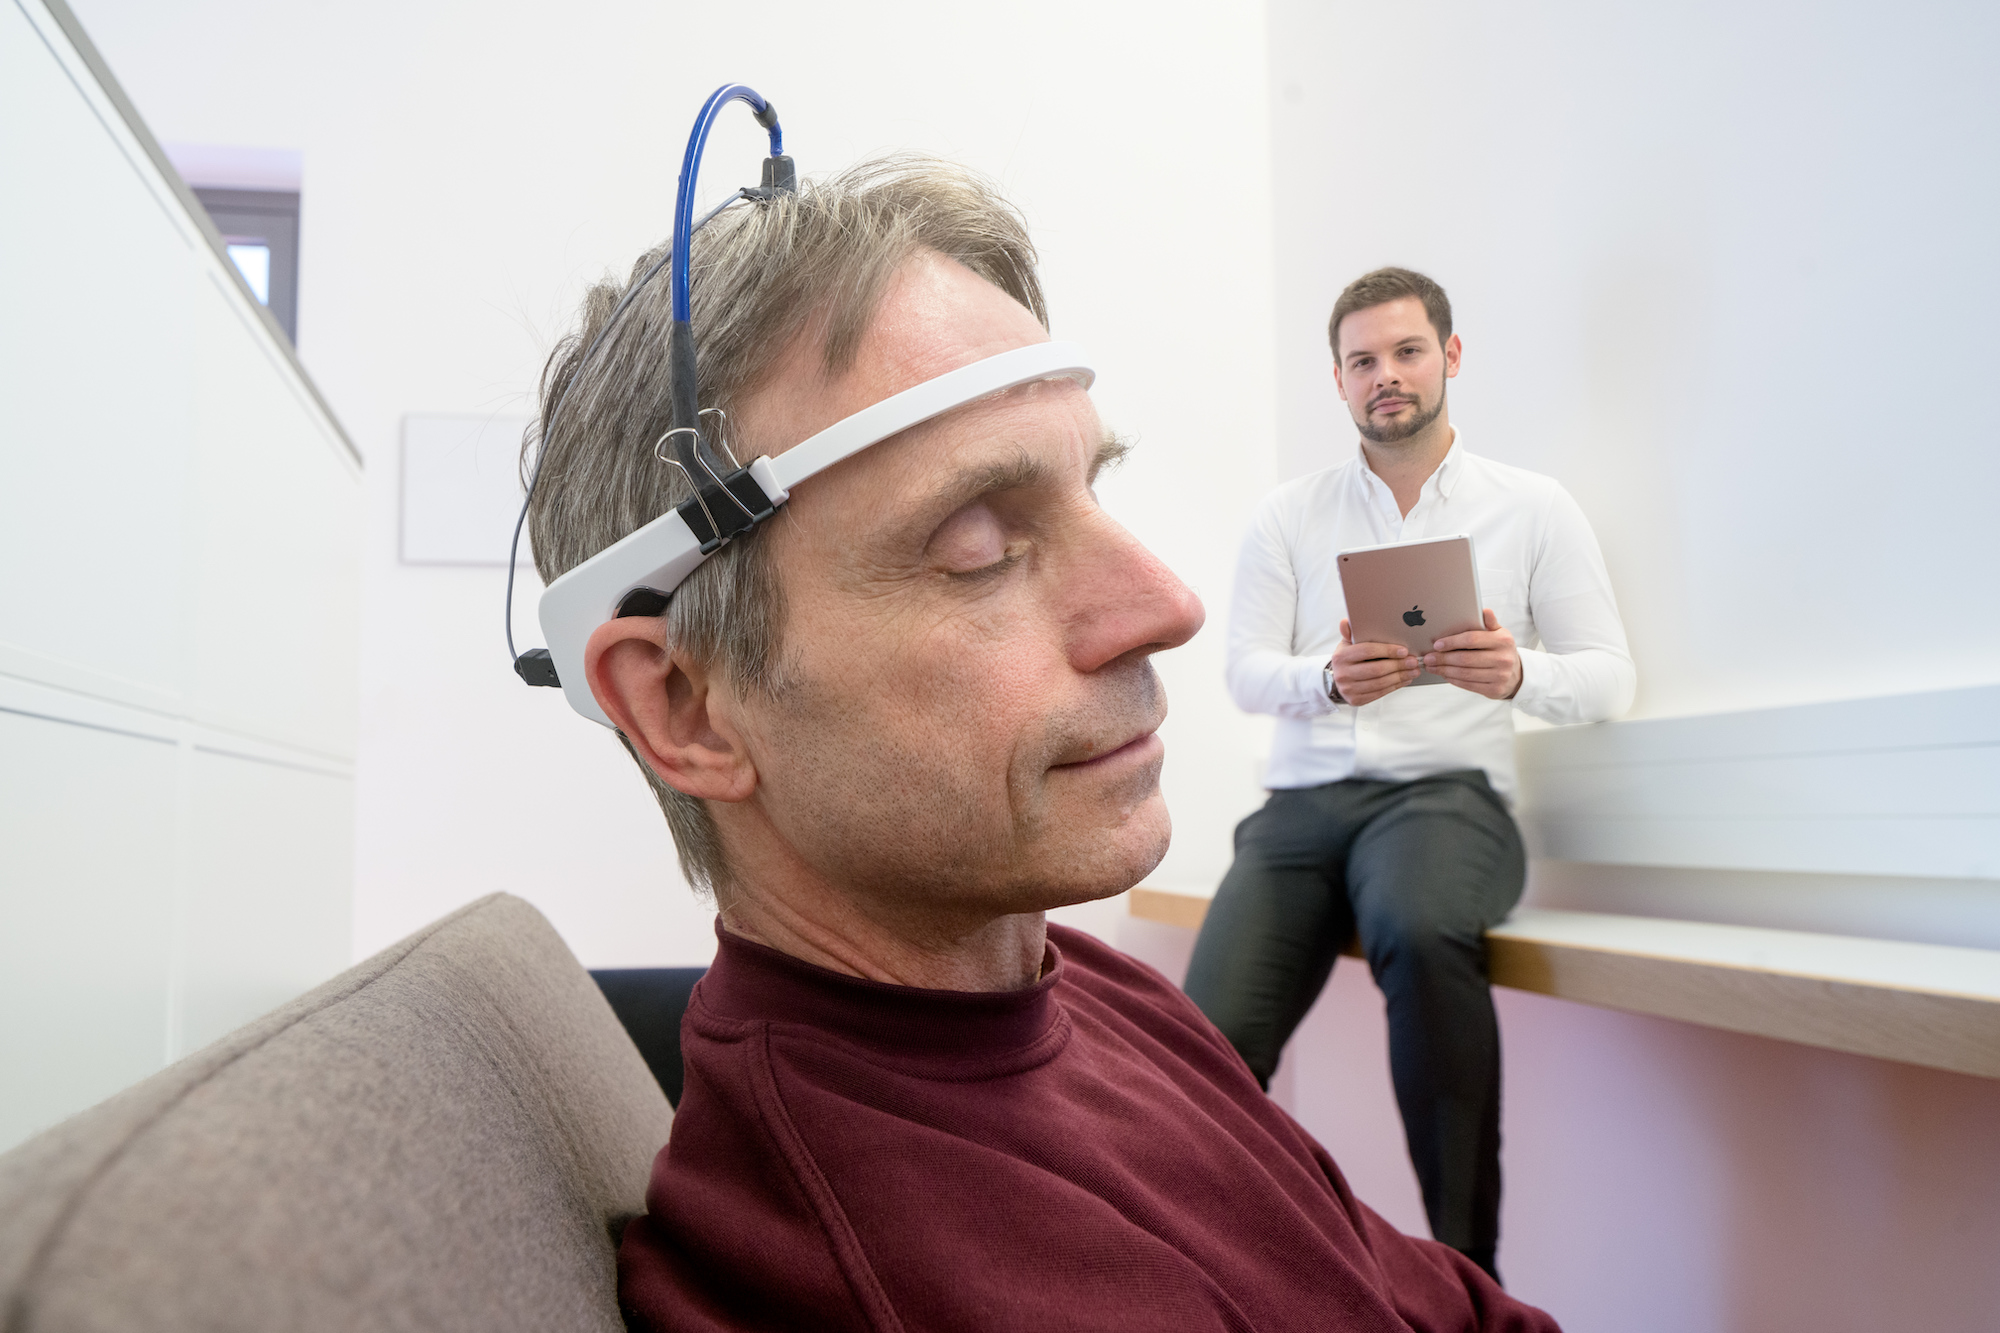
    MYND ermöglicht lebensnahe Forschung. Diese Open-Source-Software, mit der Menschen erstmals von zu Hause aus und ohne Aufsicht von Expert/innen an der Forschung im Bereich Brain-Computer-Interfaces (BCI) teilnehmen können, ist von Wissenschaftler/innen des Max-Planck-Instituts für Intelligente Systeme in Tübingen und der Universität Wien vorgestellt worden. Ihre Forschung könnte das Fachgebiet einen entscheidenden Schritt voranbringen, indem MYND die laborbasierte Grundlagenforschung durch Experimente zur Mensch-Computer-Interaktion in realen Umgebungen ergänzen kann. Die Forschenden sind zuversichtlich, dass ihr Ansatz eine tragfähige Grundlage für weitere Forschungen über die Nutzung von BCI im täglichen Leben schaffen wird.

    Der Bereich der Gehirn-Computer Interaktion (BCI) hat großes Potential sowohl für medizinische Anwendungen als auch für Technologien im privaten Bereich. Langfristig soll BCI gelähmten Menschen helfen, mit Hilfe ihrer Gedanken mit der Außenwelt zu kommunizieren. Bisher fand jedoch die meiste Forschung über BCIs zur direkten Kommunikation und Kontrolle in Laboren statt, was lebensnahe Entwicklungen auf diesem Gebiet begrenzte. Der Grund dafür ist, dass die Datenerhebung im Labor auf eine kleine Anzahl von Personen beschränkt ist und die Ergebnisse möglicherweise nicht auf reale Umstände übertragen werden können. Hinzu kommt, dass das komplexe medizinische Equipment, die in diesem Forschungsbereich verwendet wird, die Systeme für nicht fachkundige Benutzer-innen, Angehörige oder Pflegepersonal unzugänglich macht.

    Forschende des Max-Planck-Instituts für Intelligente Systeme und der Universität Wien haben sich diesen Herausforderungen nun mit MYND gestellt, einer Open-Source-Software, die alltagsfähige Aufzeichnungsgeräte mit einer einfach zu bedienenden App kombiniert. Sie präsentierten die Arbeit (“MYND: Unsupervised Evaluation of Novel BCI Control Strategies on Consumer Hardware”) 2020 auf dem ACM-Symposium on User Interface Software and Technology (UIST), einem führenden Forum für Innovationen im Bereich der Mensch-Computer-Interaktion.

    In der BCI-Forschung nutzen maschinelle Lernmodelle aufgezeichnete neuronale Aktivität, um bestimmte mentale Zustände zu erkennen. Die meisten Systeme werden jedoch nur im Labor und nicht in realen Umgebungen getestet. MYND bietet nun die Möglichkeit, Studien außerhalb des Labors mit erschwinglicher Hardware durchzuführen. MYND dient somit als Werkzeug, das erste Grundlagenforschung effektiv ergänzt, indem es Fragen zum tatsächlichen Alltagsgebrauch stellt.

    „Mit MYND hoffen wir, einen Rahmen zu schaffen, der es Forschenden ermöglicht, konzeptuelle BCI-Systeme unter realistischen Bedingungen zu evaluieren. Schließlich sollen Gehirn-Computer-Schnittstellen funktionieren, wo und wann immer Benutzer/innen sie brauchen“, sagte Matthias Hohmann, der Hauptautor der Veröffentlichung. Hohmann schloss kürzlich seine Promotion in der Abteilung Empirische Inferenz am Max-Planck-Institut für Intelligente Systeme in Tübingen ab. Die Arbeit wurde von den Forscherkolleg/innen Lisa Konieczny, Michelle Hackl, Brian Wirth, Talha Zaman, Raffi Enficiaud, Moritz Grosse-Wentrup und Bernhard Schölkopf am MPI-IS in Tübingen mit verfasst.

    „Besonders inmitten der weltweiten COVID-19-Pandemie haben wir gesehen, dass der eingeschränkte Zugang zu Laboren die Datenerfassung und die Forschung in den empirischen Wissenschaften stark beeinträchtigen kann. MYND geht diese Herausforderung effektiv an. Darüber hinaus sind wir angesichts der Ergebnisse unserer Studie zuversichtlich, dass unser Ansatz eine brauchbare Basis für die Forschung zu einer barrierefreien BCI-Nutzung im Alltag sein könnte“, so Hohmann weiter.

    Im Verlauf der MYND-Studie wurden 30 Teilnehmende gebeten, ein alltagstaugliches  Elektroenzephalogramm (EEG) zu verwenden, ein Gerät, das am Kopf angebracht wird und die neuronale Aktivität des Gehirns aufzeichnet. Die Probanden beschäftigten sich dann mit bestimmten mentalen Aufgaben: In einer ersten Aufgabe sollten sie abwechselnd an eine glückliche Erinnerung denken und eine Rechenaufgabe lösen. In der zweiten wurden sie gebeten, sich abwechselnd an ein Lied zu erinnern und eine Rechenaufgabe zu lösen. Die Teilnehmenden führten beide Aufgaben mehrmals im Laufe einer Woche durch und zeichneten dabei die neuronale Aktivität auf. Nach Abschluss der Studie waren Modelle des maschinellen Lernens in der Lage, die mentale Aufgabe aus der aufgezeichneten neuronalen Aktivität mit einer signifikanten Genauigkeit von 68,5 Prozent bzw. 64 Prozent abzuleiten.

    Die Forschenden stellten fest, dass die Erkennungsgenauigkeit – d.h. wie unterschiedlich die neuronalen Aktivitätsmuster zwischen den mentalen Aufgaben waren – mit dem Fortschreiten der Studie abnahm. Dies könnte daran gelegen haben, dass die Teilnehmenden jeden Tag die gleiche Übung durchgeführt haben. Dies, so schlagen die Forschenden vor, könnte möglicherweise behoben werden, wenn Nutzer-innen MYND dazu verwenden würden, selbst entwickelte Strategien nach einem Zeitplan ihrer Wahl zu verfolgen – etwas, das in einer traditionellen Laborumgebung nicht möglich wäre. Die Open-Source-Software eröffnet somit die Möglichkeit, die BCI-Laborforschung um Aspekte der Mensch-Computer-Interaktion zu erweitern.

    Die Open-Source-Software ist für die weitere Entwicklung und externe Forschungsbeiträge auf github verfügbar, zusammen mit einer Dokumentation und Anleitung für die wahrscheinlichsten Anpassungen, wie das Hinzufügen von neuer Aufzeichnungshardware oder experimentellen Szenarien.


    Resources

    UIST Paper (ACM Digital Library, Open Access):

    https://dl.acm.org/doi/10.1145/3379337.3415844

    UIST Talk (Youtube)

    https://www.youtube.com/watch?v=MEBZ2lwOTrk

    UIST Teaser (Youtube):

    https://www.youtube.com/watch?v=KxnbNAP2DDk

    Software Publication:

    http://doi.org/10.5281/zenodo.3802683

  • Forscherteam erhält 1,5 Millionen euro zur Entwicklung Neugieriger Lernalgorithmen

    Forscherteam erhält 1,5 Millionen euro zur Entwicklung Neugieriger Lernalgorithmen

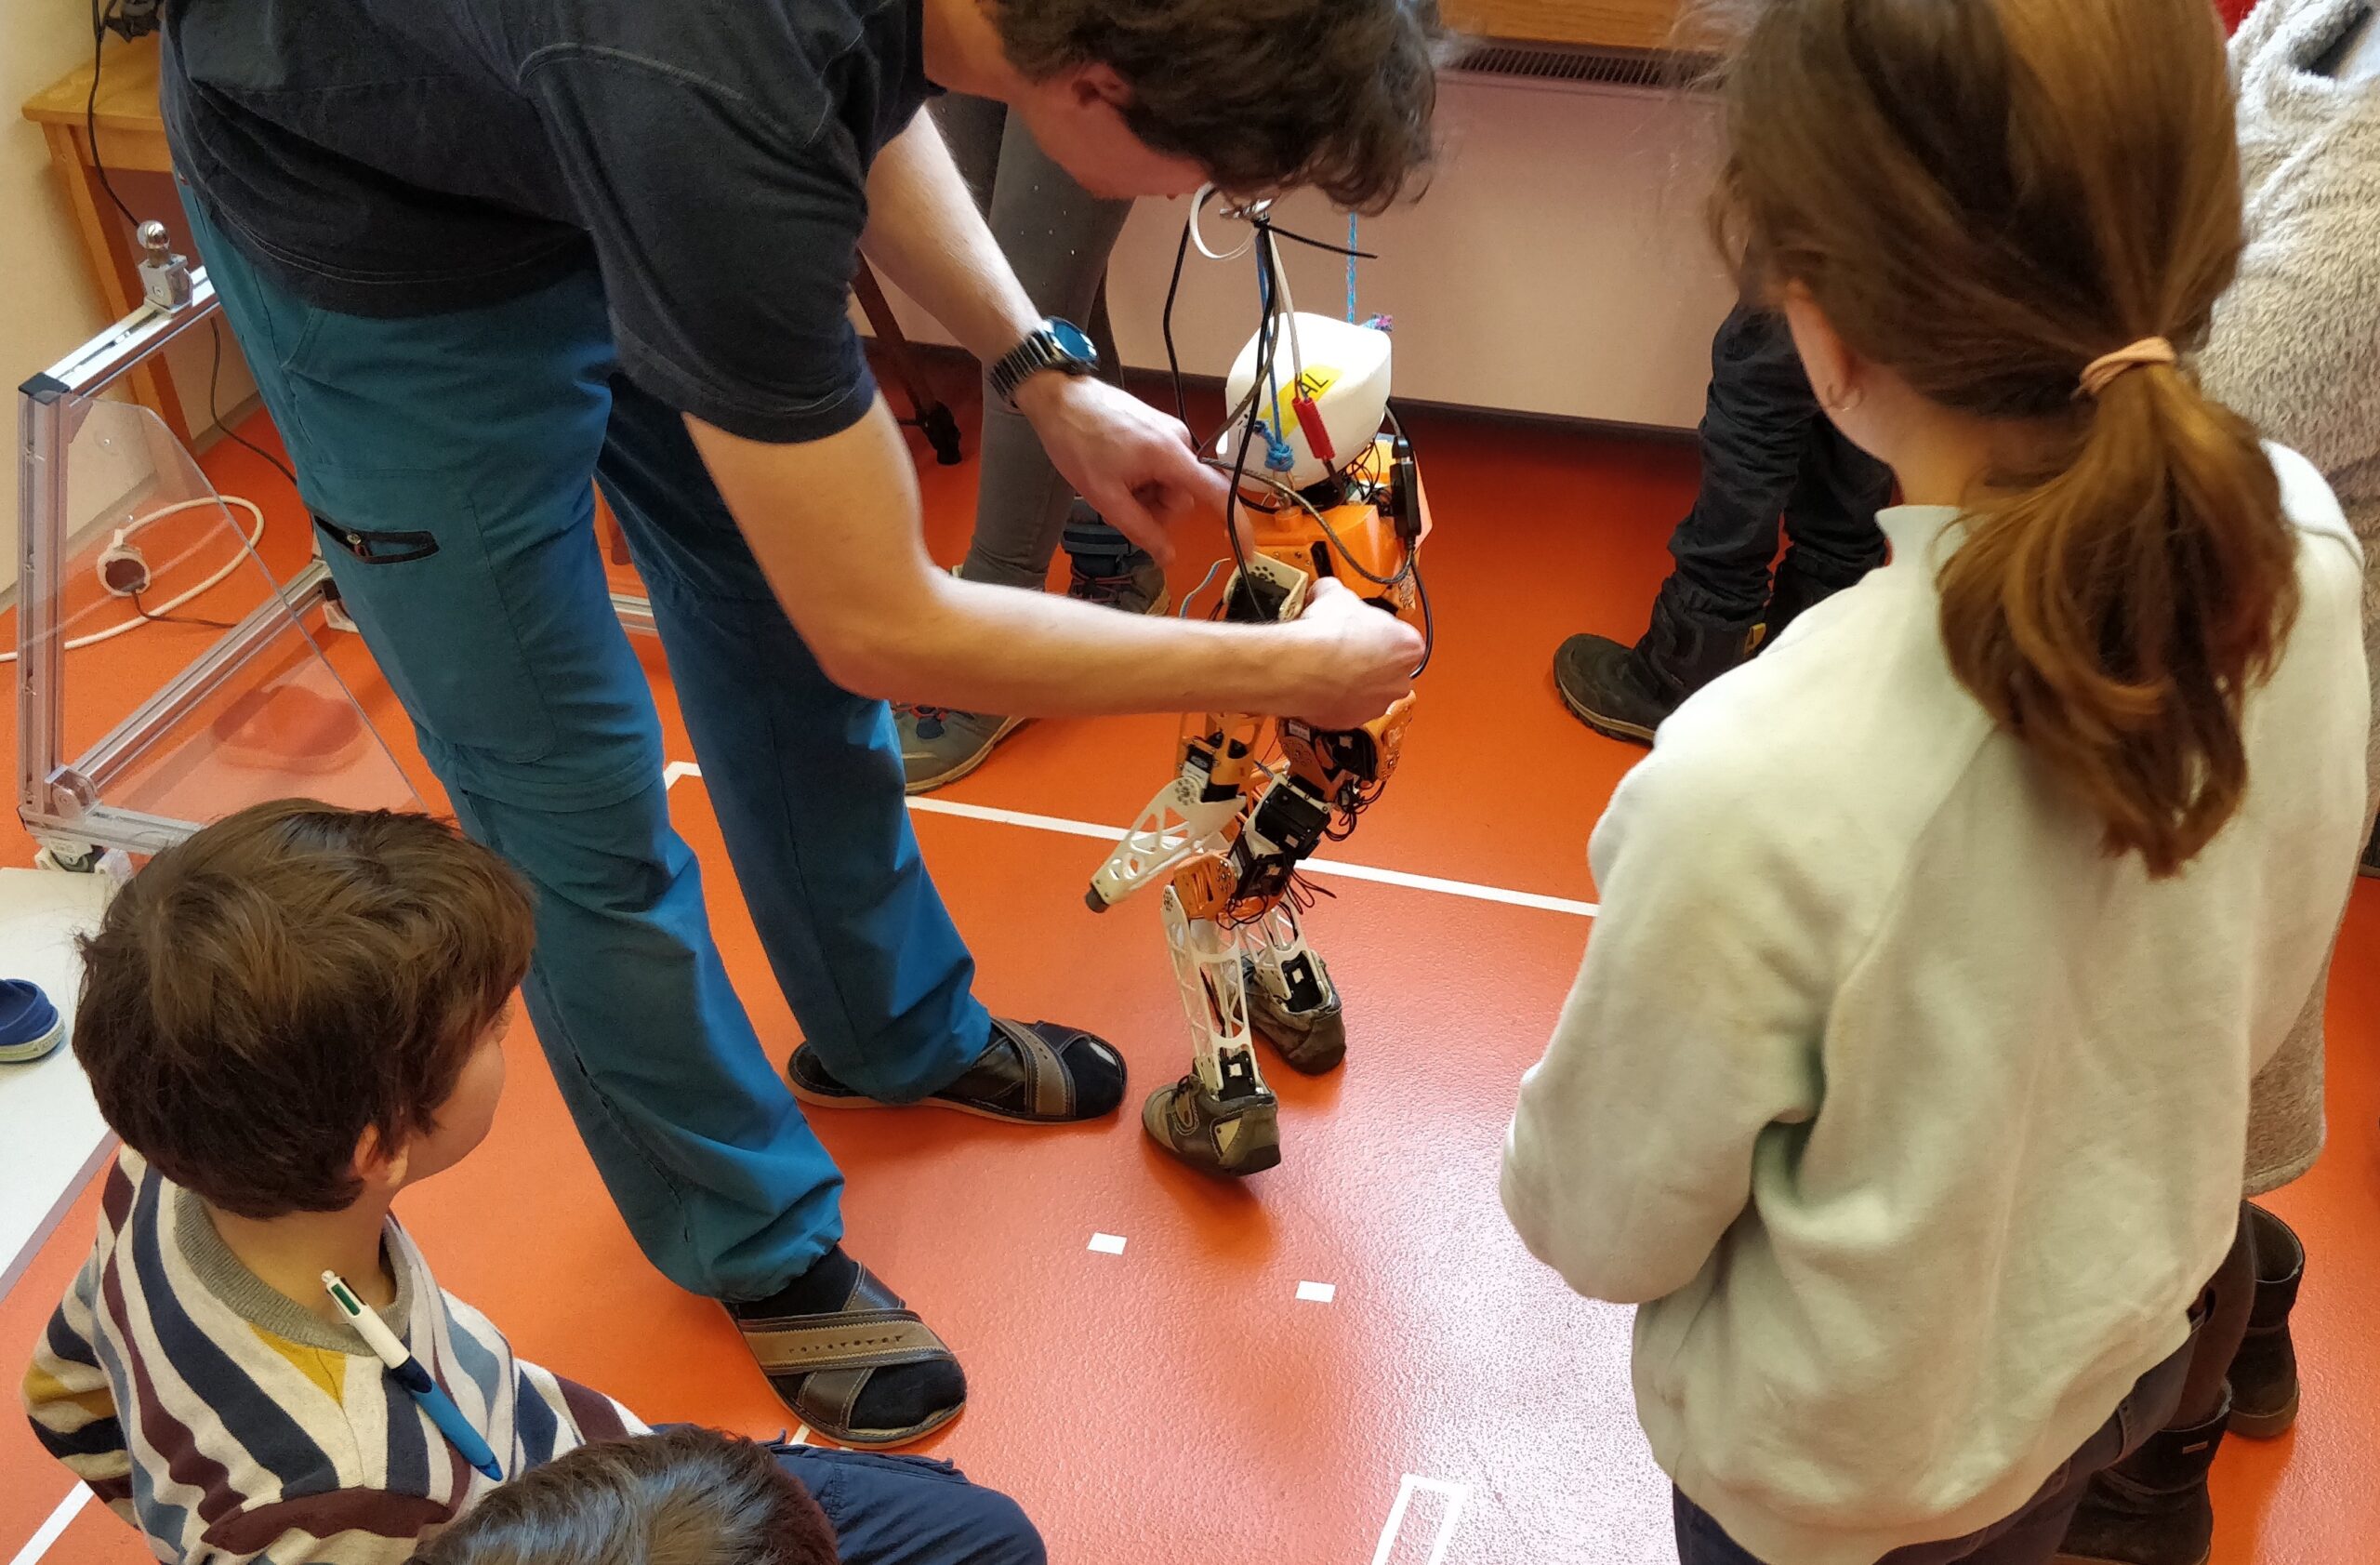
    Ein internationales Team von Wissenschaftlern an den Max-Planck-Instituten für Intelligente Systeme und für biologische Kybernetik in Tübingen sowie am Max-Planck-Institut für Bildungsforschung in Berlin erhält von der VolkwagenStiftung eine Förderung zur Entwicklung neuartiger Lernalgorithmen, die auf der Theorie kindhafter Neugier aufbauen. Ziel des Teams ist es, Neugier und Interesse in Programmcode umzusetzen, der hilft, selbstmotiviertes Lernverhalten in Robotiksysteme zu übertragen.

    Hierzu wollen die Wissenschaftler zunächst herausfinden, wie Kinder die Welt um sie herum aufgrund ihrer inneren Neugier entdecken und verstehen lernen. Auf Basis der Abstraktion und Systematisierung ihrer Lernprozesse soll die Entwicklung mathematischer Routinen es auch künstlichen intelligenten Systemen ermöglichen, kindliche Neugier zu entwickeln. In einem dritten Schritt wollen die Forscher Möglichkeiten erproben, Robotersysteme mit diesen neuen und selbstlernenden Algorithmen auszustatten.

    „Schon der berühmte Informatiker Alan Turing war der Ansicht, dass man wahre künstliche Intelligenz nur dann erreichen könne, wenn man es schaffe, eine Maschine zu bauen, die wie ein Kind lerne“, kommentiert Eric Schulz, Max-Planck-Forschungruppenleiter des Computational Principles of Intelligence Labs am Max-Planck-Institut für biologische Kybernetik. „Bisher ist jedoch wenig darüber bekannt, wie Kinder ihre Umwelt spontan erkunden und wie sich dieses Verhalten auch auf anspruchsvolle Aufgaben in der Robotik und des maschinellen Lernens anwenden lässt.“

    Ein wesentliches Merkmal menschlicher Intelligenz besteht in der Fähigkeit, die eigene Umwelt systematisch zu erforschen und zu verstehen. Dabei basiert das Erkunden nicht auf dem klassischen Lernverständnis einer von außen auferlegten Belohnungsfunktion. Vielmehr handeln vor allem Kinder stark selbstmotiviert und fordern sich heraus, im Spiel immer wieder etwas Neues zu lernen oder zu erschaffen.

    „Um diese wissenschaftliche Herausforderung zu meistern, benötigen wir noch mehr interdisziplinäre Zusammenarbeit als bisher. Forscher der Entwicklungspsychologie haben oft Probleme, ihre Erkenntnisse zum selbstmotivierten Lernen in geeignete mathematische Form zu bringen, während Computerwissenschaftler unzureichend über die Aspekte menschlicher Psychologie Bescheid wissen. In unserem Projekt wollen wir die Aufschlüsse der einzelnen Disziplinen in einem ganzheitlichen Ansatz zusammenführen und damit neue Verfahren entwickeln und neuen Einsichten erzielen“, sagt Georg Martius, Max-Planck-Forschungsgruppenleiter für autonomes Lernen am Max-Planck-Institut für Intelligente Systeme.

    Hierzu wird an den drei Max-Planck-Instituten übergreifend und in vernetzten Teams gearbeitet werden. Das Forschungsprojekt soll vor allem auch konkrete praktische Ergebnisse liefern, die sich in der Informatik und Computerwissenschaft sowie bei KI-Anwendungen entweder direkt anwenden oder weiterentwickeln lassen. Um sicherzustellen, dass die neuen Erkenntnisse Wissenschaft und Anwendung schnell und umfassend erreichen, werden alle Ergebnisse und algorithmische Codes über Open-Access-Plattformen, wie Github oder OpenAI, der Allgemeinheit zur Verfügung gestellt.

  • Legal Forms & Business Models

    Legal Forms & Business Models

    Schedule

    • Welcome 
    • Legal forms
    • Business models
    • Business models in the software industry
    • Breakout Sessions
    • Closing Remarks

    Details below | Please register here.

    Welcome

    Julia Schmaus

    Innovation Manager

     
    Introduction of the topic

    Alex Diehl

    Senior Advisor Cyber Valley

    Legal Forms

    Florian Beilhack

    Max Planck Innovation

    Q&A  
    Business models

    Marcel Werle

    University of Stuttgart

    Q&A  
    Business models in the software industry

    Marcus Rübsam

    Entrepreneur und Advisor

    Q&A


    Breakout Sessions

    Legal forms & Business models

     
    Closing and final Q&A

    Alex Diehl and Tobias Dürr

    Senior Advisor Cyber Valley
    Innovation Manager