User Group: Promovierende

  • Überlegungen zu intelligenten Systemen: eine disziplinübergreifende Definition

    Überlegungen zu intelligenten Systemen: eine disziplinübergreifende Definition

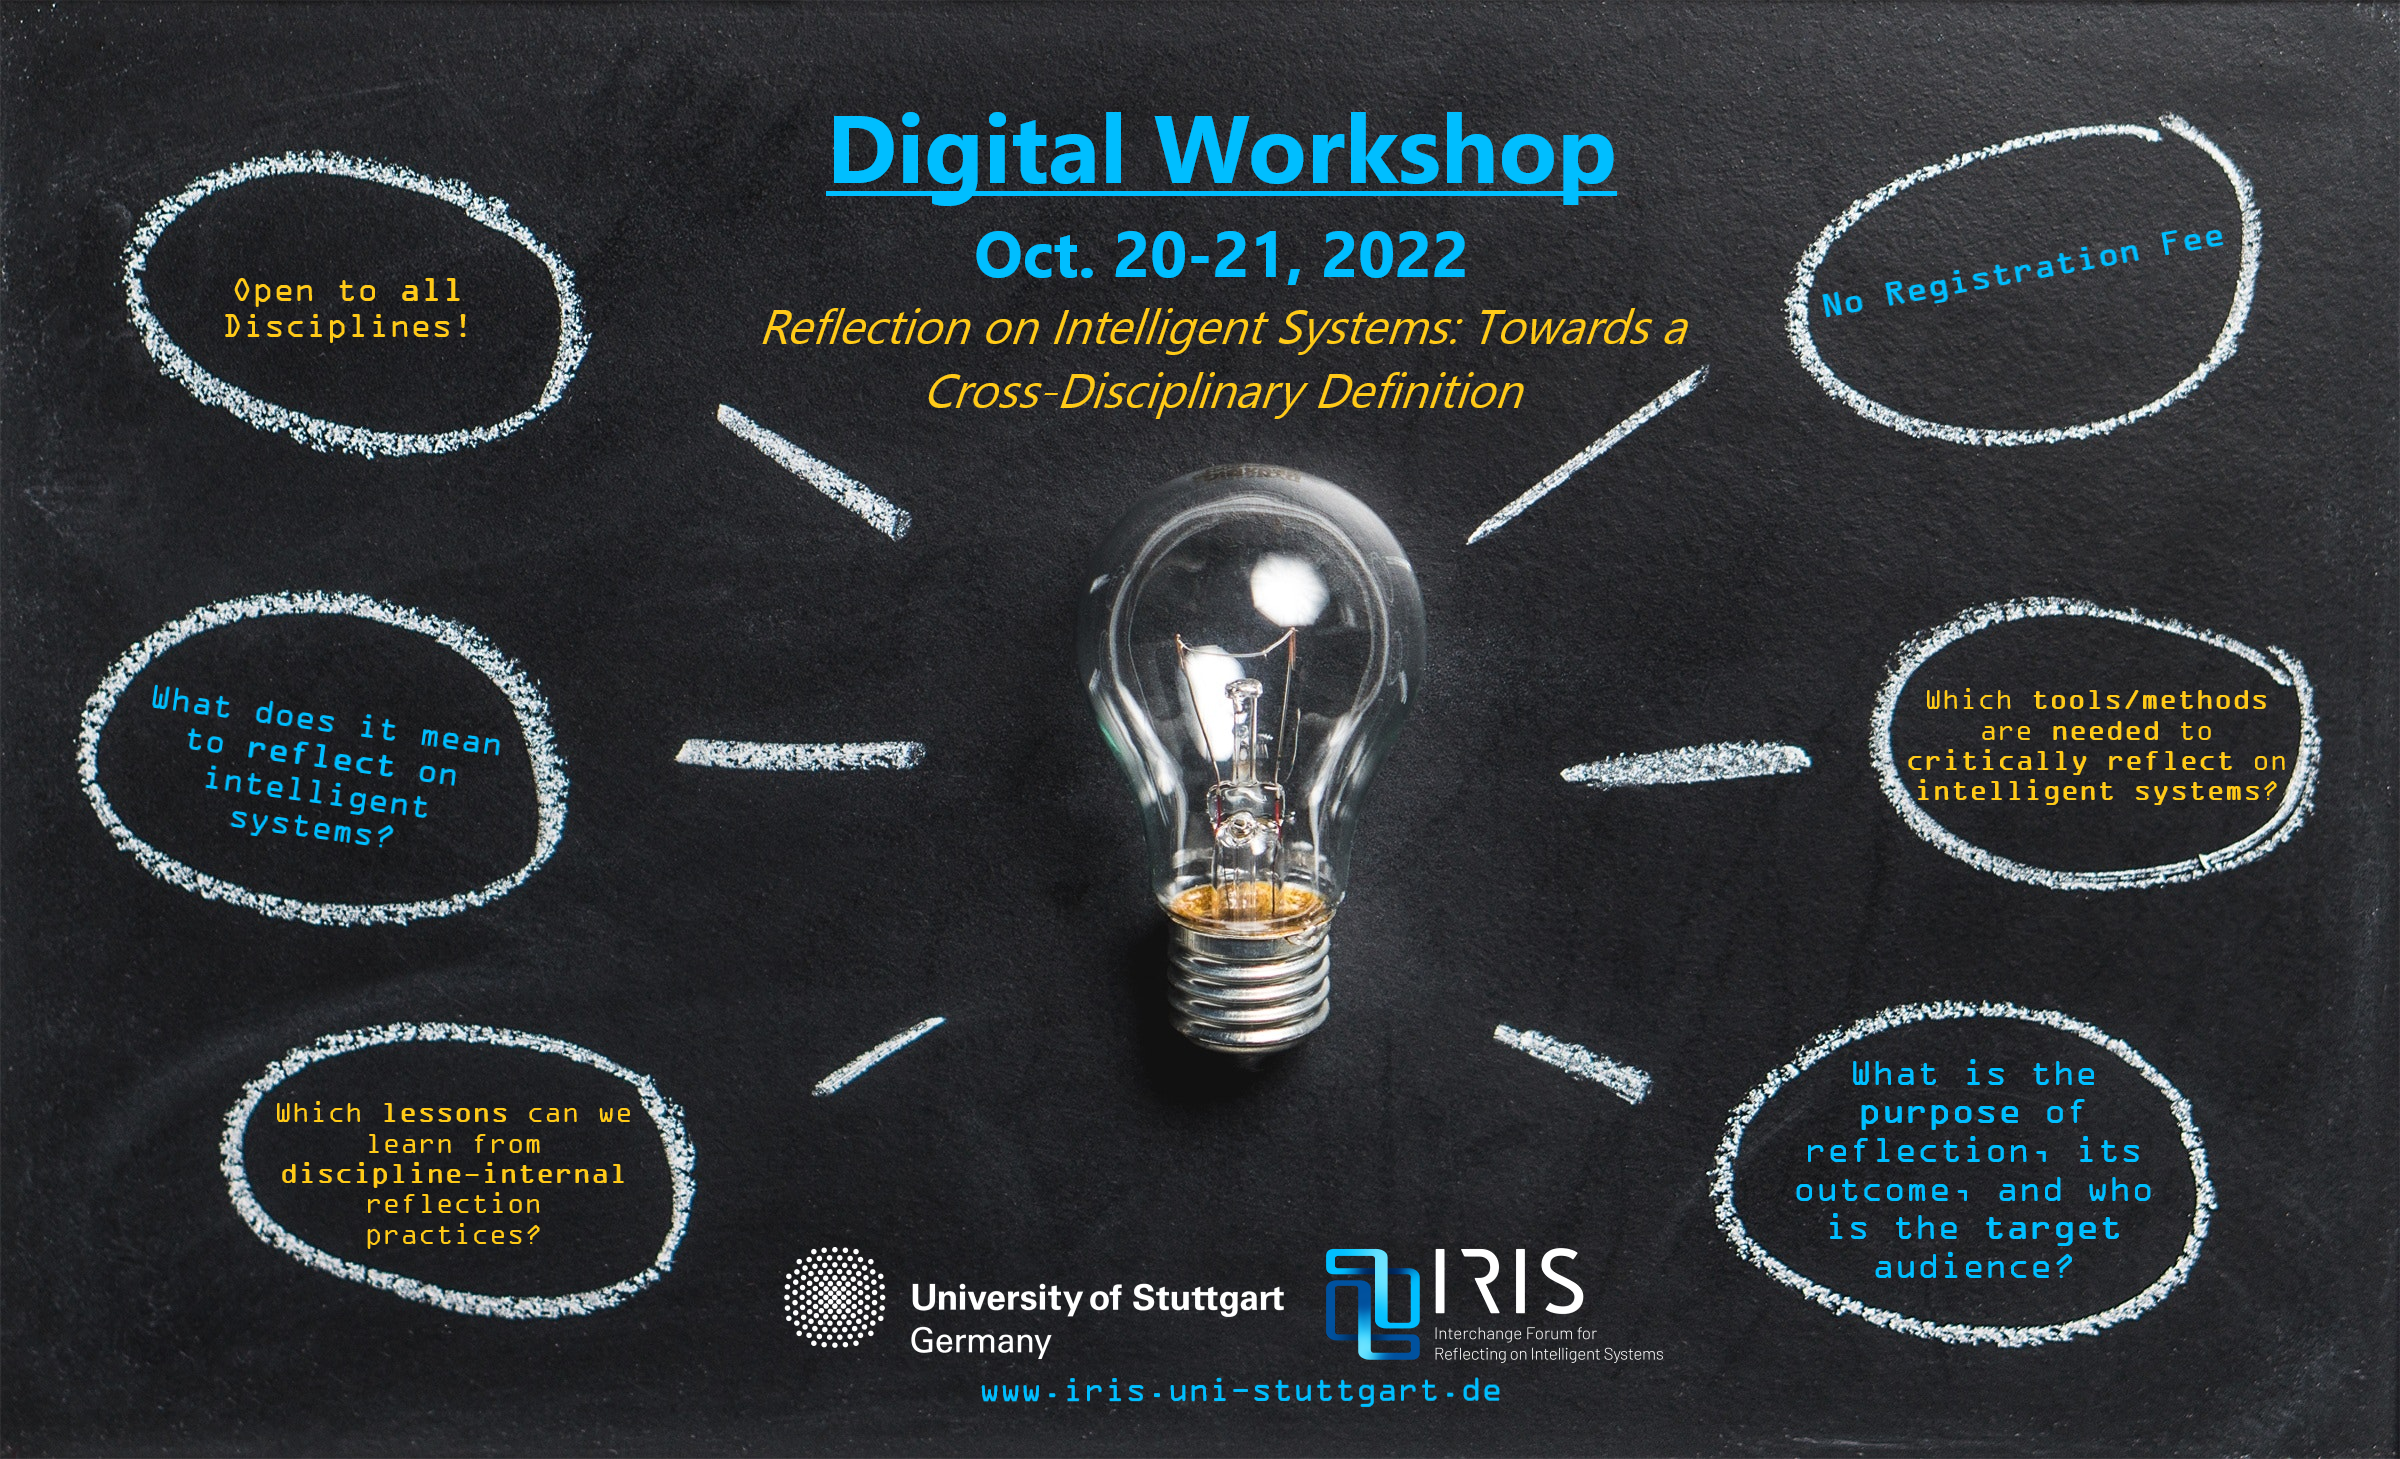
    IRIS is currently accepting submissions for this workshop!

    Submissions (2-page abstracts) should relate to one or multiple workshop themes:

    • What does it mean to reflect on intelligent systems?
    • Which tools and methods are needed to successfully engage in (critical) reflection on intelligent systems?
    • What is the purpose of this reflection, its outcome, and who is the target audience?
    • Which lessons can we learn from discipline-internal reflection practices?
    • To what extent can these lessons be “translated” into interdisciplinary collaborations, teaching, science-policy debates, and science communication to a broader public?

    We particularly encourage submissions that report on unpublished empirical or theoretical work or present relevant aspects of already published work. As this is a workshop, working papers are welcome!

    All submissions should be sent to reflection.workshop@iris.uni-stuttgart.de with a short bio by September 11, 2022. The participants will be notified of the acceptance by the end of September.

  • Ethics in tech entrepreneurship

    Ethics in tech entrepreneurship

    Beim Aufbau eines Start-ups stehen Gründer:innen vor vielen Herausforderungen, wie dem Aufbau eines Teams, der Entwicklung eines Produkts und der Gewinnung von Kunden. Daher ist es nicht immer das vorrangige Ziel von Gründer:innen, sich ausführlich mit ethischen Fragen zu befassen. In der nächsten Ausgabe unserer Cyber Valley Entrepreneurship Series werden unsere Referent:innen erläutern, warum es sehr nützlich sein kann, beim Aufbau eines Unternehmens auch ethische Aspekte zu berücksichtigen. Unsere Expert:innen geben Einblicke in verschiedene Perspektiven der Ethik für KI-Start-ups und zeigen mögliche Vorteile auf.

    Wissenschaftler:innen, Gründer:innen, Studierende und alle, die sich für das Thema „Ethics in tech entrepreneurship“ interessieren, sind herzlich eingeladen, am Donnerstag, den 23. Juni, 14:00–15:30 Uhr MESZ dabei zu sein.


    Referent:innen

    Tillmann Lang
    Gründer & CEO, Inyova Impact Investing GmbH

    Michael Raschke
    CEO Blickshift GmbH

    Ulrich Hemel
    Direktor Weltethos-Institut in Tübingen

    Zhijing Jin
    MPI-IS, Abteilung Empirische Inferenz

    Rebecca C. Reisch
    Geschäftsführerin Cyber Valley


    Registrierung

    Bitte hier registrieren. Das Event findet via Zoom und in englischer Sprache statt.


    Kontakt

    Oliwia Gust, Cyber Valley Event Managerin
    Telefon: +49 7071 601 1554
    Mobil: +49 151 4075 6302 
    E-Mail: oliwia.gust@cyber-valley.de

  • 3. Workshop zu geistiger Anstrengung

    3. Workshop zu geistiger Anstrengung

    Umfang und Ziel des Workshops 

    Wir alle können uns nach einem Arbeitstag erschöpft fühlen, selbst wenn wir ihn am Schreibtisch verbracht haben. Das intuitive Konzept der geistigen Anstrengung durchdringt praktisch alle Bereiche der menschlichen Informationsverarbeitung und ist zu einem zentralen Bestandteil allgemeiner Kognitionstheorie geworden. Die uneinheitliche Verwendung dieses Begriffs in den kognitiven Wissenschaften, einschließlich der kognitiven Psychologie, der Pädagogik, des Human Factors Engineering und der künstlichen Intelligenz, machen ihn zu einem der am wenigsten klar definierten theoretischen Konstrukte in diesem Bereich.

    Einige neuere Ansätze legen den Grundstein für einen Konsens, indem sie geistige Anstrengung einheitlich definieren. Um jedoch einen feldübergreifenden Konsens über die Operationalisierung geistiger Anstrengung zu erreichen, ist ein Austausch zwischen verschiedenen empirischen und rechnerischen Ansätzen erforderlich, einschließlich symbolischer Architekturen, nicht-parametrischer Bayes-Statistik und neuronaler Netze. Ziel dieses zweitägigen Workshops ist es, diese neuen Perspektiven zu besprechen und miteinzubeziehen. 

    Um dieses Ziel zu erreichen, haben wir Experten auf diesen Gebieten dazu eingeladen, eine Zusammenfassung ihrer Forschung zu präsentieren. Außerdem gibt es mit praktischen Übungen, einer Podiumsdiskussion und einer Postersitzung die Gelegenheit, mit dem Publikum in Dialog zu treten.

    Zu den wichtigsten Fragen, die diskutiert werden sollen, gehören unter anderem:

    • Welche experimentellen Phänomene bilden die Grundlage für Theorien zu geistiger Anstrengung?
    • Welche Gemeinsamkeiten gibt es bei der Operationalisierung geistiger Anstrengung in den verschiedenen Bereichen der Kognitionswissenschaft?
    • Welche Modellierungsansätze sind am besten geeignet, um welche Fragen in Bezug auf geistige Anstrengung zu beantworten?

    Der Workshop ist speziell auf Forschende mit Fachwissen in verschiedenen Modellierungsdisziplinen ausgerichtet.

    Programm

    Workshop-Tag 1, 21. November 2022, Übungen 
    • An Introduction to Biologically-Inspired Neural Network Modeling
      (Randall O’Reilly, University of California, Davis)
    • An Introduction to ACT-R
      (Maria Wirzberger, Universität Stuttgart)
    • Bayesian Models in Brain Science
      (Andra Geana, Brown University)
    • Hierarchical Bayesian parameter estimation of the Drift Diffusion Model
      (Michael J. Frank, Brown University)
    • Network Dynamic Modeling of Cognitive Control
      (Anastasia Bizyaeva, Princeton University)
    • Reinforcement Learning
      (Hanneke den Ouden, Radboud University)
    Workshop-Tag 2, 22. November 2022, Forschungsgespräche
    • Keynote: Daniel Kahneman (Princeton University)
    • Danielle Bassett (University of Pennsylvania)
    • Michael Inzlicht (University of Toronto)
    • Yuko Munakata (University of California, Davis)
    • Amitai Shenhav (Brown University)

    Wichtige Termine 

    • Registrierung & Einreichung der Poster-Abstracts: 26. August 2022
    • Workshop-Tag 1: 21. November 2022, Übungen
    • Workshop-Tag 2: 22. November 2022: Forschungsgespräche

    Aufruf zur Einreichung von Abstracts und Anmeldung

    Sie arbeiten an einem Projekt oder einer Dissertation zum Thema geistige Anstrengung und möchten Ihre Ideen diskutieren? Wenn ja, laden wir Sie dazu ein, diese während unserer virtuellen Postersitzung zu präsentieren.

    Bitte reichen Sie für Ihre Bewerbung einen Abstract (2.000 Zeichen) als Teil des Anmeldeformulars ein.

    Kontaktinformation:

  • Wissensbasiertes maschinelles Lernen und seine Anwendungen

    Wissensbasiertes maschinelles Lernen und seine Anwendungen

    Trotz der bemerkenswerten Fortschritte, die in den letzten Jahrzehnten bei den Techniken des maschinellen Lernens (ML) und bei datengesteuerten Verfahren der künstlichen Intelligenz allgemein erzielt wurden, sind die meisten ML-Ansätze derzeit nicht in der Lage, interpretierbare Informationen und Wissen aus Daten zu extrahieren. Außerdem können Vorhersagen, die aus rein datengesteuerten Modellen gewonnen werden, physikalisch inkonsistent oder sogar unplausibel sein. Derzeit wird intensiv untersucht, wie man vorhandenes (Experten-)Wissen in das ML-Design einbeziehen kann, um diesen Herausforderungen zu begegnen. Die sorgfältige Integration von Vorwissen über einen Prozess, wie z. B. physikalische oder chemische Erkenntnisse, in das Lernverfahren verbessert nicht nur die Qualität der gelernten Repräsentation, sondern beschleunigt auch den Lernprozess mit weniger Datenproben.

    Diese Summer School zielt darauf ab, den Teilnehmenden ein grundlegendes Verständnis dafür zu vermitteln, wie verschiedene Aspekte des Wissens inkl. etablierter Simulationsparadigmen in moderne Lernarchitekturen eingebracht werden können.

    Confirmed speakers

    Zielgruppe

    Die SimTech Summer School richtet sich in erster Linie an Masterstudierende, Promovierende und early PostDocs.

  • Call for papers: Künstliche Intelligenz und Nachhaltigkeit

    Call for papers: Künstliche Intelligenz und Nachhaltigkeit

    Hintergrund für diesen Call for Paper ist, künstliche Intelligenz (KI) und Nachhaltigkeit zu kombinieren und zu untersuchen, wie KI-Lösungen es ermöglichen könnten, die Herausforderungen der nachhaltigen Entwicklung zu bewältigen.

    Die Forschung zu den Beziehungen zwischen KI und Nachhaltigkeit konzentriert sich meist auf Modelle und Algorithmen des maschinellen Lernens für die ökologische Säule der Nachhaltigkeit, mit besonderem Schwerpunkt auf Klimawandel, Verkehr und Mobilität, nachhaltige Landwirtschaft, Abfallwirtschaft, Biodiversität, Energie oder Umweltverschmutzung. Die Literatur beleuchtet jedoch widersprüchliche Beiträge der KI, die sowohl positive Auswirkungen hat, indem sie beispielsweise die Folgen der Klimakrise verringert oder den Klimawandel vorhersagt, als auch auf negative Folgen eingeht, KI beispielweise eine Quelle der Umweltverschmutzung darstellt. Darüber hinaus befassen sich nur wenige Studien mit der Verbindung zwischen KI und gesellschaftlichen oder wirtschaftlichen Aspekten der Nachhaltigkeit, und die vorhandenen Ergebnisse scheinen ebenso uneindeutig zu sein.

    In einer Welt, in der KI und Nachhaltigkeit von größter Bedeutung sind, sind daher weitere Forschungsarbeiten erforderlich, und die Wissenschaftler:innen sind aufgefordert, die potenziellen Synergien und Wechselwirkungen zwischen KI und Nachhaltigkeit zu erforschen und aufzudecken, wobei die dreifache Bilanz (Triple Bottom Line) zu berücksichtigen und ein mehrstufiger Ansatz zu verwenden ist. Aufkommende Fragen beziehen sich auf die Rolle von Unternehmen als Übermittlende, Vermittlende und/oder Nutzende von Informationen, staatliche Programme und Politik, geistiges Eigentum und freier Zugang, nachfrageseitige Interventionen, wie einflussreiche Verbraucherkollektive, oder bürgerschaftliches und politisches soziales Bewusstsein. Die Beiträge könnten Sektoren wie (aber nicht nur) Landwirtschaft, Bildung und Ausbildung, Raumfahrt, Finanzen, Biochemie, Energie oder Gesundheit behandeln.

    Vorgeschlagene Paper könnten folgende Themen umfassen (nicht limitierend):

    • Kompatibilität und Wechselwirkungen zwischen KI und Nachhaltigkeit
      Sind KI und Nachhaltigkeit miteinander vereinbar? Welche Verbindungen gibt es zwischen KI und Nachhaltigkeit (Rollen und Auswirkungen)? Kann KI nachhaltig sein? Wo liegen die Grenzen der KI in einem nachhaltigen Umfeld? Welcher theoretische Rahmen ist am besten geeignet, um Fragen der KI und der Nachhaltigkeit zu behandeln?
    • Rolle, Funktionen und Interaktionen zwischen KI-Akteuren in Bezug auf die nachhaltige Entwicklung
      Wer sind die KI-Akteure? Wie sind sie organisiert? Inwieweit unterstützt das derzeitige KI-Ökosystem die Nachhaltigkeit? Was sind die größten Herausforderungen der KI-Akteur:innen? Wie nehmen sie Nachhaltigkeit wahr?
    • Erforschung der Beziehung zwischen künstlicher Intelligenz und Nachhaltigkeit aus einer multiskaligen Perspektive
      Was sind die Akzeptanzfaktoren von KI in einem nachhaltigen Umfeld? Was sind die wirtschaftlichen und sozialen Auswirkungen für Kund:innen, Bürger:innen, Unternehmen, Regierungen oder internationale Institutionen? Was sind die Auswirkungen speziell für kleine und mittlere Unternehmen und Start-ups? Was sind die regulatorischen Auswirkungen? Welches sind die wichtigsten Herausforderungen für die Zukunft?
    • Verantwortungsvolle Forschung und Innovation im Kontext von KI und Nachhaltigkeit
      Wie kann KI nachhaltige Forschung und Innovation verändern und fördern? Wie kann KI eine nachhaltige Innovation fördern?

    Einreichungsfrist ist der 30. November 2022. Weitere Informationen über den Aufruf zur Einreichung von Beiträgen und das Einreichungsverfahren finden Sie in der beigefügten PDF-Datei oder auf der unten stehenden Website.

  • Cyber Valley Start-up Incubation Program

    Cyber Valley Start-up Incubation Program

    Inhalt

    Ihr braucht kein Team, keine Vorkenntnisse und kein Gründungsprojekt. Alle Werkzeuge, die ihr für eine erfolgreiche Gründung benötigt, werden euch zur Verfügung gestellt. Gemeinsam mit erfahrenen Start-up Coaches erhaltet ihr Einblicke in Themen wie Team Building, Marktanalyse, Proto- und Pretotyping, Businessmodelle und Start-up Pitches. Am Ende bekommt ihr die Chance, euer Start-up Projekt vor einer hochklassigen Jury zu präsentieren und ihr könnt wertvolle Preise gewinnen.

    Zielgruppe

    Der Inkubator richtet sich an alle Wissenschaftler:innen aus dem Cyber Valley Ökosystem – und darüber hinaus. Doktorand:innen der International Max Planck Research School for Intelligent Systems (IMPRS-IS) erhalten darüber hinaus 3 Credit Points, wenn sie den Kurs erfolgreich absolvieren.

    Ablauf und Termine

    Der Inkubator ist als sechswöchiges Programm geplant mit jeweils einem Vor-Ort-Workshop pro Woche (10:00–18:00). Die einzelnen Termine werden abwechselnd in Stuttgart und Tübingen stattfinden. Es wird einen Shuttlebus für Teilnehmer:innen des jeweils anderen Standortes geben. Sollte die Pandemie Vor-Ort-Veranstaltungen nicht erlauben, wird die Veranstaltung virtuell stattfinden. Die Termine sind:

    • Freitag, 1. April 2022
    • Freitag, 8. April 2022
    • Freitag, 22. April 2022
    • Freitag, 29. April 2022
    • Freitag, 6. Mai 2022
    • Freitag, 13. Mai 2022 (finales Pitch Event)

    Bewerbung

    Um sich für das Cyber Valley Start-up Incubation Program zu bewerben, wird ein Lebenslauf und ein Motivationsschreiben benötigt. Aus dem Motivationsschreiben (ca. eine Seite) soll hervorgehen, warum die Bewerber:innen sich für das Programm interessieren und welches Problem aus ihrem (Forschungs-)Alltag sie mit einem Start-up gerne lösen möchten. Doktorand:innen benötigen außerdem eine schriftliche Erlaubnis ihrer Doktormutter oder ihres Doktorvaters, dass sie an den sechs Terminen teilnehmen dürfen (eine E-Mail genügt).

    Nur noch wenige Plätze verfügbar. Bitte sendet euren Lebenslauf, euer Motivationsschreiben und die schriftliche Erlaubnis eurer Doktormutter bzw. eures Doktorvaters an tobias.duerr@cyber-valley.de.

    Sprache

    Das Programm wird in englischer Sprache angeboten.

    Fragen?

    Wendet euch gerne an Tobias Dürr, wenn ihr Fragen habt.


  • ML beschleunigt industriellen Optimierungsprozess

    ML beschleunigt industriellen Optimierungsprozess

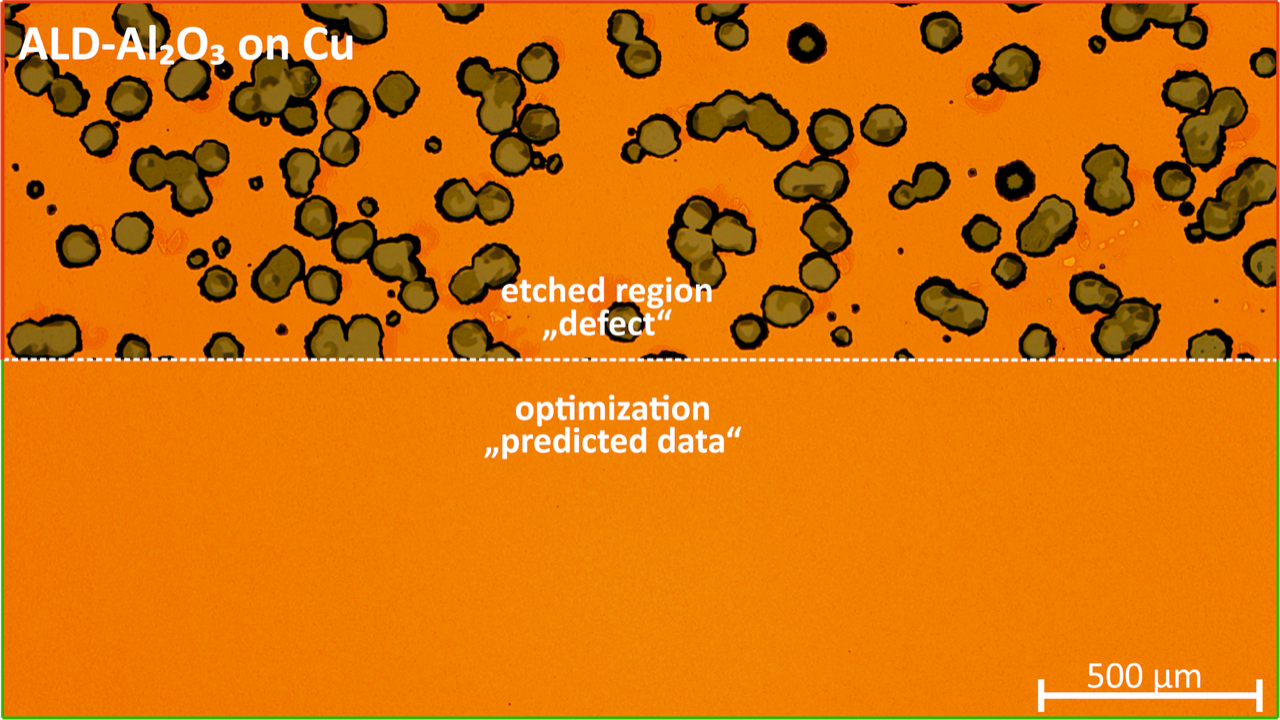
    Ein interdisziplinäres Forscherteam des Max-Planck-Instituts für Intelligente Systeme, des Max-Planck-Instituts für Festkörperforschung, der Technischen Universität München und der Robert Bosch GmbH setzt Methoden des Bayes’schen Maschinellen Lernens (ML) ein, um den Optimierungsprozess von Kupferbeschichtungen für Mikrochips zu beschleunigen. Auf diese Weise kann das Verfahren im Vergleich zu einem herkömmlichen Optimierungsansatz um das Fünfzehnfache beschleunigt werden.

    Mikrochips sind praktisch fester Bestandteil eines jeden elektrischen Produkts. Ein Metall, das bei der Herstellung dieser Chips sehr häufig zum Einsatz kommt, ist Kupfer. Das weiche Metall ist für die Herstellung von Mikrochip-Produkten unverzichtbar, da es Strom und Wärme hervorragend leitet. Damit jedoch Kupfer sein volles Potenzial entfalten kann, darf es nicht korrodieren. Daher wird bei der Herstellung von Mikrochips das Kupfer mit einer dünnen Schicht Aluminiumoxid überzogen. Dieser Verkapselungsprozess nennt sich Atomic Layer Deposition – kurz ALD.

    Die Optimierung des Beschichtungsprozesses ist langwierig und kostspielig

    Die Beschichtung von Kupfer ist ein schwieriges Verfahren. Es erfordert viel technisches Know-how, viele Stunden manuelle Arbeit und zahlreiche Versuche, um die optimalen Parameter zu finden, damit am Ende die Schicht fehlerfrei (d. h. ohne Löcher, Dellen oder Lücken) und möglichst dünn aufgetragen ist. Das ist erstens wichtig, weil ein Mikrochip gerade mal so groß ist wie eine Hausstaubmilbe, es also nur wenig Platz gibt. Zweitens ist Aluminiumoxid kostspielig: Bei der Produktion von Tausenden, wenn nicht gar Millionen von Mikrochips, machen sich selbst ein paar Nanometer in der Gewinnspanne bemerkbar. Drittens sind Löcher, Lücken und Dellen unerwünschte Einfallstüren für Korrosion.

    Ein interdisziplinäres Team von Forschenden des Max-Planck-Instituts für Intelligente Systeme, des Max-Planck-Instituts für Festkörperforschung, der Technischen Universität München und der Robert Bosch GmbH – einem Industriepartner im Forschungsverbund Cyber Valley – hat eine Methode entwickelt, Defekte in der Schicht zu minimieren, den Optimierungsprozess zu beschleunigen und die Kosten für die Beschichtung von Kupfer zu senken. Sie setzten Bayes’sche Methoden des maschinellen Lernens ein und beschleunigten so den Optimierungsprozess um das Fünfzehnfache.

    Bayes’sche Optimierung

    „Unebenheiten in der Beschichtung können durch eine dickere Beschichtung reduziert werden, aber das kostet mehr und die Schicht nimmt immer größeren Raum ein. Für Ingenieure sind viele Iterationen erforderlich, um die ideale Beschichtung mit wenigen bis gar keinen Fehlern zu finden. In der Industrie dauert es noch länger, Wochen oder Monate, und kostet daher Tausende von Euro pro Iteration. Daher ist es eine große Leistung, den Optimierungsprozess durch Bayes’sche Optimierung von 30 oder 40 Arbeitsschritten auf nur zwei oder drei zu reduzieren“, sagt Gül Dogan, Doktorandin der Abteilung für Moderne Magnetische Systeme am Max-Planck-Institut für Intelligente Systeme (MPI-IS) und der Robert Bosch GmbH. Sie ist Erstautorin der Publikation Bayesian Machine Learning for Efficient Minimization of Defects in ALD Passivation Layers, die in der Zeitschrift Applied Materials and Interfaces veröffentlicht wurde.

    Abbildung 1: Während das System neue Datenpunkte sammelt – die blauen Markierungen im unteren Bild – aktualisiert es die Vorhersage über das System, und auf der Grundlage dieser Vorhersage schlägt die Bayes’sche Optimierung einen neuen zu testenden Parametersatz vor.

    „Wir nutzen maschinelles Lernen, um bessere Ergebnisse zu erzielen als konventionelle Optimierungsmethoden. Unser Algorithmus arbeitet mit den Experten zusammen und lernt aus ihren Erfahrungen – mit Erfolg: Wir haben in dem Aluminiumoxid-Schutzfilm so gut wie keine Porosität und reduzieren damit die Korrosion erheblich“, ergänzt Sinan Demir, Doktorand der Abteilung für Physische Intelligenz am MPI-IS, die von Prof. Metin Sitti geleitet wird.

    Wie gut die Beschichtung gelingt, hängt von mehreren Parametern ab: wie lange die Kupferoberfläche mit einem Ar/H2-Plasma vorbehandelt und damit gereinigt wird, von der Abscheidetemperatur von über 200 °C und der Pulsdauer von 60 ms beim Aufbringen des Aluminiumoxids. Alle Parameter und ihr Zusammenspiel beeinflussen die Korrosionsbeständigkeit. Der Algorithmus ist in der Lage, den optimalen Parametersatz in nur wenigen Iterationen zu finden.

    Gelerntes auf andere Prozesse übertragen

    „Nehmen wir an, die Leistung des Optimierungsprozesses ist durch diese orangefarbene Funktion in Abbildung 1 definiert. Nehmen wir an, dass unsere Parameter den Optimierungsprozess entsprechend dieser Funktion beeinflussen. Wir beginnen ohne jegliches Vorwissen. Wenn wir neue Datenpunkte sammeln – die blauen Marker im unteren Bild – aktualisieren wir die Vorhersage über das System. Auf der Grundlage dieser Vorhersage schlägt die Bayes’sche Optimierung einen neu zu testenden Satz an Parametern vor, der die Leistung des Systems verbessern kann. Dann führen wir das Experiment unter Verwendung dieses neuen Parametersatzes durch. Wir fahren so lange mit dem Testen und der Auswahl neuer Parametersätze fort, bis wir unser Ziel oder unsere Designvorgabe erreicht haben“, so Demir weiter.

    Die Beschichtung von Kupfer ist nur eine Herausforderung. In den Materialwissenschaften gibt es noch viele weitere. „Das ist der Vorteil der Bayes’schen Methoden des maschinellen Lernens: Die Erkenntnisse, die man aus einem Optimierungsprozess gewinnt, lassen sich auf andere Materialien und Prozesse in allen Bereichen der Materialwissenschaft übertragen. Man fängt nicht jedes Mal bei Null an“, sagt Demir abschließend.

  • Scientific Symposium

    Scientific Symposium

    Schedule (CET)

    Wednesday January 12
    12:45-1:00 pm Opening remarks
    1:00-2:30 pm Presentations | Part One
    2:30-3:00 pm Break
    3:00-4:30 pm Presentations | Part Two
    Thursday January 13
    8:45-9:00 am Opening remarks
    9:00-10:30 am Presentations | Part Three
    10:30-11:00 am Break
    11:00 am – 12:30 pm Presentations | Part Four

    Presentations:

    Towards Machines that See the World like Humans

    In the past few years, deep neural networks have surpassed human performance on a range of complex cognitive tasks. However, unlike humans, these models can be derailed by almost imperceptible perturbations, often fail to generalize beyond the training data and require large amounts of data to learn novel tasks. A core reason for this behavior is shortcut learning, i.e. the tendency of neural networks to pick up statistical signatures sufficient to solve a given task instead of learning the underlying causal structures and mechanisms in the data. My research ties together adversarial machine learning, disentanglement, interpretability, self-supervised learning, and theoretical approaches like nonlinear Independent Component Analysis to develop theoretically grounded yet empirically successful visual representation learning techniques that can uncover the underlying structure of our visual world and close the gap between human and machine vision.

    An Algorithmic Safety View of Learning in Human-centered Domains

    Machine Learning advances have revolutionized many domains such as machine translation, complex game playing, and scientific discovery. On the other hand, ML has only enjoyed modest successes in human-centered applications. To improve the utility, reliability, and robustness of Machine Learning (ML) models in human-centered domains, we need to address several foundational challenges. In this talk, I will demonstrate how an algorithmic-safety perspective can motivate specific technical challenges for learning in human-centered domains such as healthcare. Specifically, I will discuss the need to improve the utility of ML-robustness, explainability with an emphasis on decision-making, and post-hoc algorithmic safety to prevent harm. I will discuss my contributions on i) novel methods to improve causal robustness of ML methods designed for practical generative settings, ii) aiding safe decision-making in non-IID settings using time-series explainability intended to address clinicians’ requirements, and iii) novel learning algorithms to optimize for post-deployment safety in sequential decision-making settings. I will conclude with an overview of my future research vision on novel safety-based objectives for explainability in ML, expanding ML-based solutions to general and practical generative settings, and outlining novel ways of validating ML models targeting safety-based objectives.

    On Inferential Challenges in Modern Machine Learning

    Machine learning (ML) can be viewed as solving two types of inferential tasks: inferring models from data and inferring knowledge from models. Central to this perspective is the development of fast, accurate inference methods for model parameters and latent variables. In this talk, I will present my work on addressing inferential challenges in modern ML which are characterized by enhanced model complexity and massive datasets that demand algorithms at scale. I will focus on 1) theory and methods of score estimation, an emerging tool for dealing with intractable probability densities in today's highly expressive ML models, and 2) orthogonal inducing points, an inferential idea that advanced the state-of-the-art of scalable uncertainty models in ML. Finally, I will discuss future directions that connect these ideas to generative modeling, continual learning, and how they could help us understand deep learning.

    Computer Vision for Global-scale Biodiversity Monitoring

    We require a real-time, modular earth observation system that unites efforts across research groups in order to provide the vital information necessary for global-scale impact in sustainability and conservation in the face of climate change. The development of such systems requires collaborative, interdisciplinary approaches that translate diverse sources of raw information into accessible scientific insight. For example, we need to monitor species in real time and in greater detail to quickly understand which conservation efforts are most effective and take corrective action. Current ecological monitoring systems generate data far faster than researchers can analyze it, making scaling up impossible without automated data processing. However, ecological data collected in the field presents a number of challenges that current methods, like deep learning, are not designed to tackle. These include strong spatiotemporal correlations, imperfect data quality, fine-grained categories, and long-tailed distributions. My work seeks to overcome these challenges, and includes methods which can learn from imperfect data, systematic frameworks for measuring and overcoming performance drops due to domain shift, and the deployment of efficient human-AI systems that have made significant real-world conservation impact. My future research agenda will expand upon the strong foundation built by my past and current research. It will seek to make effective use of all available modalities of data, incorporate expert knowledge systematically, and ensure these systems are equitable and ethical – all fundamental and unresolved challenges for CV&ML.

    Open-World Learning for Biomedicine

    Biomedical data poses multiple hard challenges that break conventional machine learning assumptions. In this talk, I will highlight the need to move beyond our prevalent machine learning paradigms and methods to enable them to drive novel biomedical discoveries. I will focus on open-world deep learning methods that generalize to new scenarios never seen during training and demonstrate the impact they have in single-cell genomics. I will first present a method that transfers knowledge across heterogeneous datasets generated under different distributions, and then describe the paradigm needed to discover previously unobserved phenomena. I will discuss the biological findings enabled by these methods and the conceptual shift they bring in annotating comprehensive single-cell atlas datasets. Altogether, my work demonstrates that generalization to never-before-seen scenarios is not only possible, but it is a necessary component in developing next-generation methods that can reveal new scientific insights.

    Social Robots for Health and Education

    I build innovative social robots that address important challenges in health care and education. A unifying challenge that I address in my work is that most of the existing resources that treat complex health and learning problems are developed for professionals. My vision is to democratize health care and education by using social robots to break barriers of access to these critical domains. Towards this, I designed, developed, fabricated, and deployed robots capable of reciprocal interactions with humans to be used as valuable sources of knowledge and assistance that empower people to make decisions about their mental health, social-emotional learning, and creativity. My work probes the intersection of the fields of Human-Robot Interaction, Human-Centered Design, and Artificial Intelligence as essential building blocks for creating social robots that can empower human health and education.

    Intelligent Soft Systems – How Fundamental Physical Principles Enable Function

    Functional soft materials promise to revolutionize robotics hardware by providing entirely new functions and by allowing robots to perform better than traditional robots made from materials such as metals and electromagnetic motors. Over the last decade a large variety of intelligent systems based on functional soft materials have been successfully demonstrated. However, only the surface of the capabilities of these new types of materials has been skimmed, because the fundamental materials behavior, from which they derive their functionality, is often not sufficiently understood.

    In this talk, I discuss fundamental physical principles of soft materials, which can enable function in high-performing soft devices. First, I describe how snap-through instabilities in elastomeric structures can be exploited for electronics-free control of robots. Then, I discuss how the electromechanical coupling between electric fields and soft structures enables electroactive devices and artificial muscles. Finally, I outline nonlinear and thermomechanical effects, which have the potential to serve as the basis for the next generation of intelligent soft systems.

    Advanced Multimodal Locomotion and Multifunctionality of Soft-bodied Millirobots

    Large individually-controlled degrees of freedom (DOF) in animal epidermises enable the animals to dynamically and dexterously interact with their natural environment for diverse functions. This capability still holds at small length scales: flatworms, starfish larvae, corals, comb jellyfishes, and millipedes utilize their numerous individually-controlled cilia, tube feet, or tiny legs for highly adaptable locomotion and multiple functions, such as nutrient transportation, predation, and bio-mixing. Despite their significant future potential applications and numerous recent advances, current miniature (centi-/millimeter) robots still do not have similar tiny cilia, feet, or legs in their epidermises to dynamically and dexterously interact with their operation environment, which severely limits their locomotion capabilities and functionalities.

    The presentation will first walk through my previous projects of using physical intelligence, such as soft design, flow structure interaction, and metachronal coordination, to enhance miniature robots' locomotion capability and functions. Then, I will briefly discuss how I support these investigations on robotics by innovating on micro-fabrication and novel materials. At last, I will propose a new methodology to address the prementioned scientific challenge directly. Such an approach would immediately augment the functional interaction of various miniature robots with their surrounding environments, leading to disruptive locomotion and manipulation capabilities for various future applications.

    Structured Learning – Encoding Structure from Physics, Algorithms, and Geometry into Machine Learning for Robotics and Computer Vision

    This talk focuses on the interaction of structural assumptions and machine learning. While modern machine learning (aka deep learning) is able to leverage large amounts of data and computation to achieve important results, I believe that the recent shift of the community towards ever more general learning approaches is flawed. The progress of deep learning so far has relied heavily on advances in computation, data collection, and software libraries. But as such improvements are plateauing, future progress in AI requires us to reevaluate the role of structure in learning and to tightly integrate both for better data efficiency, generalization, and explainability. In this talk, I will present how structure from physics, algorithms, and geometry can be encoded in learning approaches to robotics and computer vision and why we need a better fundamental understanding of the interaction of structure, learning, and optimization.

    Towards Democratic Learning and Collective Intelligence

    An ability to generalize to unseen environments is of paramount importance in machine learning. In order to equip artificially intelligent systems with such capability, it is necessary to deal with various forms of distributional shifts and to distinguish between spurious correlations and genuine ones in the observed data. To this end, the first part of this talk will be about the Hilbert space embedding of distributions, or kernel mean embedding (KME) for short, which is a nonparametric kernel-based framework to represent probability distributions and model changes thereof. In particular, I will focus on how this framework can help improve the credibility of algorithmic decision making based on observational data by enabling us to reason about higher-order causal effects of policy interventions as well as by removing the effect of unobserved confounders through the use of an instrumental variable (IV) and a proxy variable. In the second part of this talk, we will take a sober look at the foundation of learning and generalization. In order to build intelligent systems that can truly generalize to the real world, we must take a step back and question the traditional definition of generalization and standard procedures in machine learning. Since society is made up of a set of diverse individuals, demographic groups, and institutions, learning and deploying algorithmic models across heterogeneous environments face a set of various trade-offs. I will argue that in such heterogeneous environments, creating machine learning frameworks that allow for real-world generalization is reminiscent of designing algorithms that respect the democratic principle.

    Diversity and Inequality in Social Networks

    Online social networks often mirror inequality in real-world networks, from historical prejudice, economic or social factors. Such disparities are often picked up and amplified by algorithms that leverage social data for the purpose of providing recommendations, diffusing information, or forming groups. In this talk, I discuss an overview of my research involving explanations for algorithmic bias in social networks, briefly describing my work in information diffusion, grouping, and general definitions of inequality. Using network models that reproduce inequality seen in online networks, we'll characterize the relationship between pre-existing bias and algorithms in creating inequality, discussing different algorithmic solutions for mitigating bias.

    Towards Principled Algorithmic Support of Human Decision-Making

    Many important applications such as hiring, healthcare, and scientific peer review rely on human decision-making. Recently, the scale of many of these applications has increased dramatically which is both an opportunity and a challenge. On the one hand, the large amount of data generated in these applications opens up an opportunity to take a novel data-centric perspective on the classical problems of human decision-making. On the other hand, the large scale makes it hard or even impossible for humans to do all the work manually; hence, there is a challenge of developing principled algorithmic tools to support human decision-makers. In this talk, I will discuss my work on exploring the opportunities and addressing the challenges in the context of scientific peer review. In that, I will talk about empirical and theoretical work that has impacted major Computer Science conferences such as NeurIPS and ICML. I will then outline ideas for future work.

  • It’s not the same river

    It’s not the same river

    Der Exzellenzcluster „Integrative Computational Design and Construction for Architecture“ (IntCDC) an der Universität Stuttgart veranstaltet die IntCDC Constructive Conversations, bei denen renommierte nationale und internationale Wissenschaftler und Industrieexperten zu aktuellen Themen und Herausforderungen im Bereich IntCDC sprechen.

    Die kommende IntCDC Constructive Conversations Session wird mit Aviad Almagor, Division Vice President, Emerging Technologies bei Trimble, stattfinden. Aviad Almagor hat sich auf einen sehr frustrierenden, aber auch sehr lohnenden Bereich spezialisiert – die Einführung und Umsetzung neuer Technologien in Unternehmensmärkten – kein Job für schwache Nerven. Seine Rolle erfordert flexible Hartnäckigkeit, sachkundige Ignoranz, Akrobatik und geistige Beweglichkeit. Aviad hat einen Master-Abschluss der Universität Cambridge, einen MBA-Abschluss der Heriot-Watt University, Schottland, und einen B.Arch-Abschluss des Israeli Institute of Technology.

    Aviad Almagor – Division Vice President, Emerging Technologies at Trimble

    Foto: Aviad Almagor – Division Vice President, Emerging Technologies, Trimble

    Die Veranstaltung findet digital über WebEx und in englischer Sprache statt. Um an der Veranstaltung teilzunehmen, klicken Sie hier.

  • Call for Papers

    Call for Papers

    Für den digitalen Workshop „Literature & Culture and/as Intelligent Systems“ haben die Universität Stuttgart und das Interchange Forum for Reflecting on Intelligent Systems (IRIS) einen Call for Papers gestartet.

    IRIS möchte in einem Workshop Literatur und Kultur sowohl in Bezug auf intelligente Systeme als auch als intelligente Systeme untersuchen. Die Darstellungen intelligenter Systeme in literarischen Texten wird ebenso erörtert wie die Frage, inwieweit Literatur und Kultur selbst als intelligente Systeme betrachtet werden können. Beiträge sind von Wissenschaftler:innen aller Karrierestufen, Hintergründe und Disziplinen willkommen.

    Deadline ist der 29. Oktober.

    Weitere Informationen gibt es auf der IRIS Webseite.