
Die Weiterentwicklung der künstlichen Intelligenz (KI) erfordert nicht nur eine ethisch und sozial reflektierte Forschung, sondern auch einen Dialog zwischen Wissenschaft und Gesellschaft. Doch wie können Forschende und Bürger:innen bei einem so komplexen Thema auf Augenhöhe miteinander ins Gespräch kommen? Rebecca Beiter, Cyber Valley Public Engagement Managerin, berichtet in der Online-Ringvorlesung über ihre Erfahrungen mit verschiedenen Formaten, die den Dialog zwischen Wissenschaft und Gesellschaft fördern und fordern. Neben den Besonderheiten zum Dialog über KI legt der Vortrag auch einen Fokus auf Public Engagement im Allgemeinen. Wie unterscheidet sich Public Engagement von klassischer Wissenschaftskommunikation? Welche Idee steht dahinter und welche Werte sollte Public Engagement vertreten? Beiter berichtet über die Arbeit an einem Public-Engagement-Kodex und der Möglichkeit, sich daran zu beteiligen.
Der Vortrag findet online statt; eine Anmeldung ist nicht notwendig. Sie können diese Veranstaltung in einem Zoom-Webinar-Raum verfolgen. Die Zugangsinformationen finden Sie zeitnah auf der Startseite der Ringveranstaltung. Die Ringvorlesung veranstaltet die Universität Ulm in Kooperation mit der Bundesarbeitsgemeinschaft Wissenschaftliche Weiterbildung (BAG WiWA).
User Group: Wissenschaftler:innen
-
Ringvorlesung: KI – Dialog zwischen Wissenschaft und Gesellschaft
-
Sprechstunde: Cyber Valley Start-up Incubation Program
Das Cyber Valley Start-up Incubation Program bietet für Master-Studierende sowie für Forscherinnen und Forscher im April und Mai 2022 die Gelegenheit auszuprobieren, ein KI-Startup zu gründen – in nur sechs Wochen. Alle Informationen zum Cyber Valley Incubation Program findest du auf dieser Seite. Bewerbungsschluss ist am 13. März 2022.
Hast du noch Fragen? Cyber Valley Innovationsmanager Tobias Dürr bietet Interessierten eine dreißigminütige Sprechstunde an, in denen er deine Fragen zum Programm beantwortet. Die Sprechstunde ist am 2. März um 14 Uhr, am 3. März um 11 Uhr und am 7. März um 15 Uhr. Über diesen Link können sich Interessierte zu diesen Zeiten einwählen.
-
Fingerspitzengefühl für Roboter
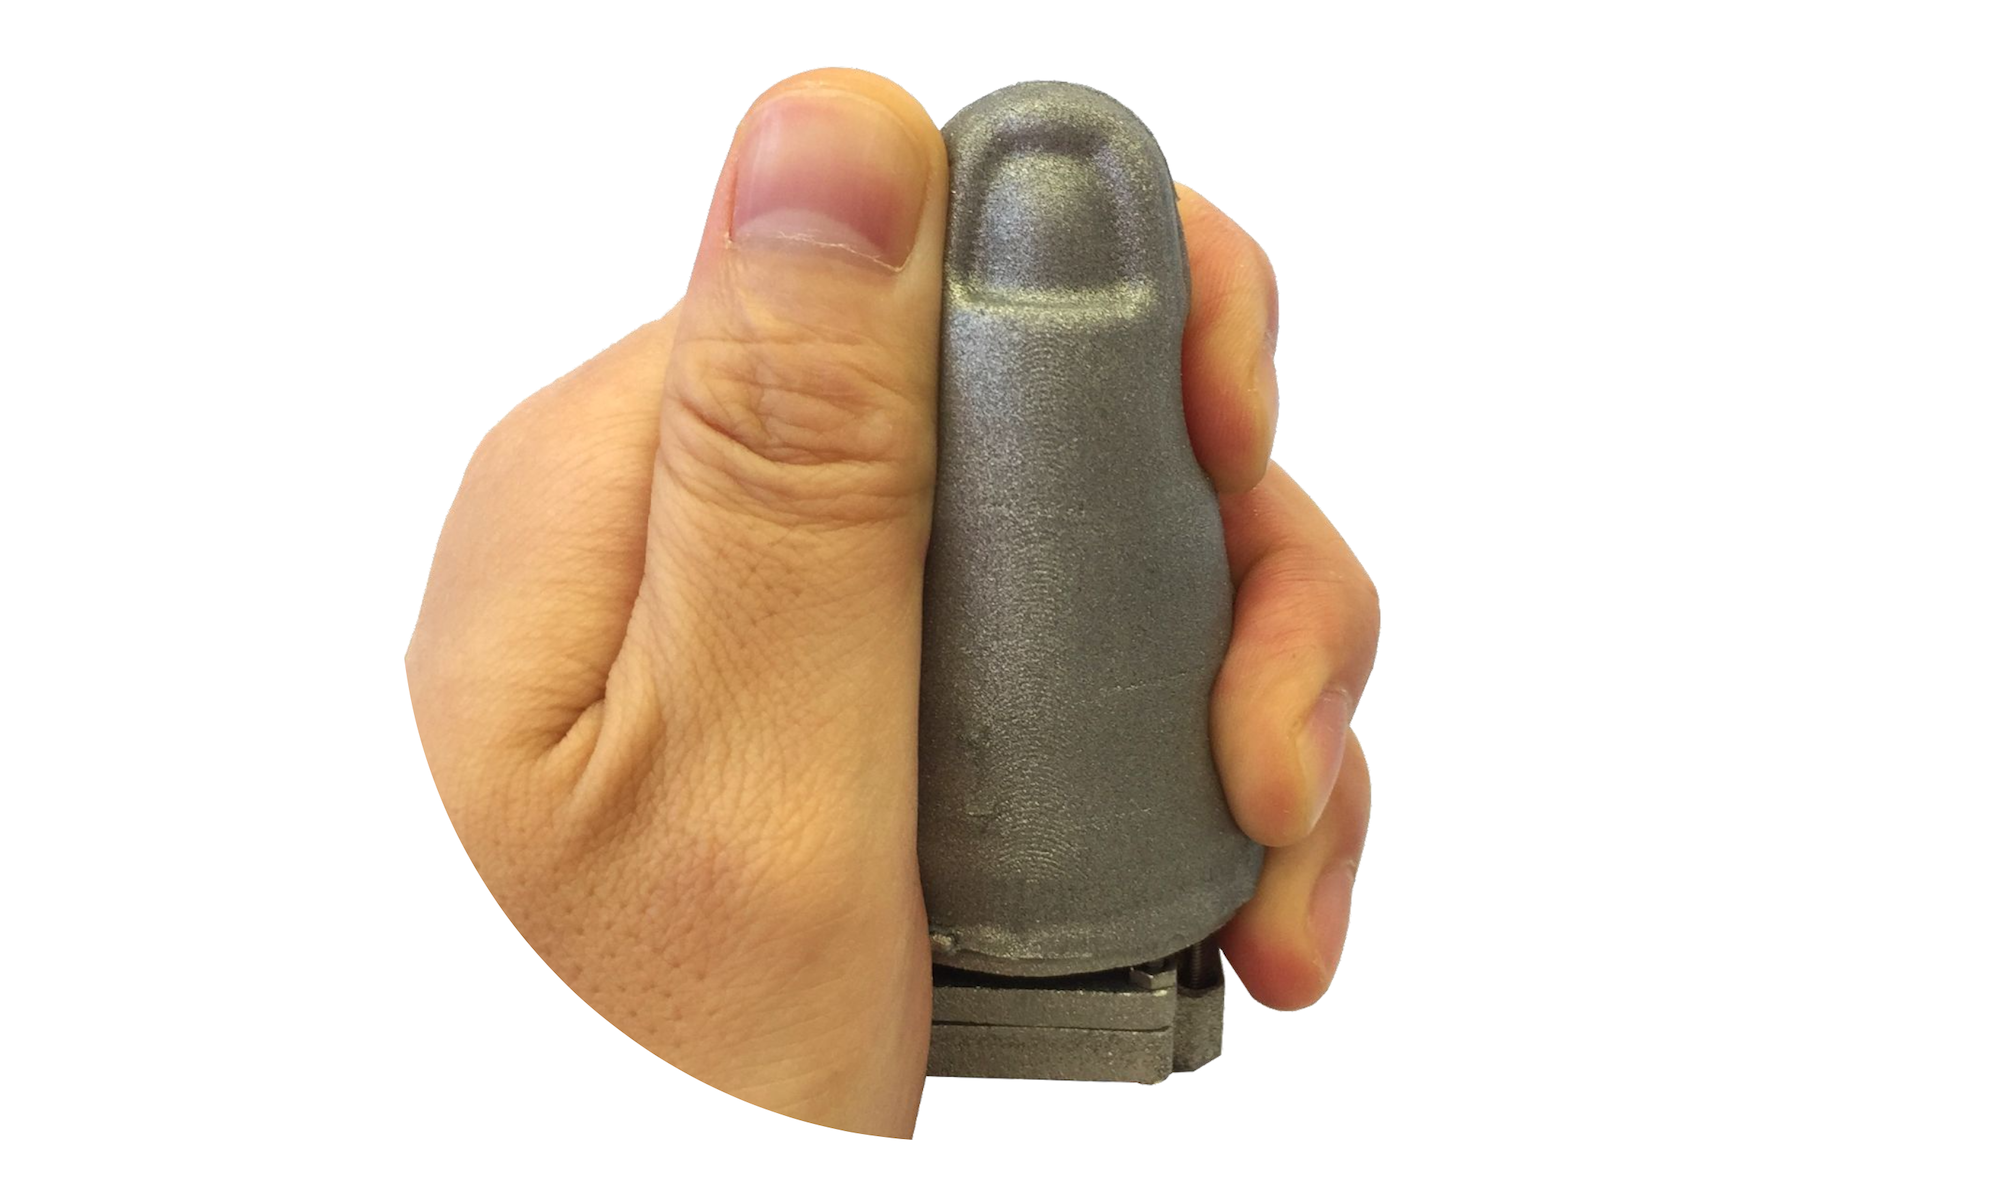
In dem Bestreben, den Tastsinn von Robotern zu verbessern, entwickeln Wissenschaftler:innen des Max-Planck-Instituts für Intelligente Systeme einen Sensor, der einem Daumen gleicht und im Inneren mit einer Kamera ausgestattet ist. Das Team trainiert ein tiefes neuronales Netz, um aus den Kamerabildern Informationen abzuleiten, wo und wie stark der Sensor berührt wird. Aus gefilmten Verformungen der flexiblen Außenhülle des Sensors generiert das neuronale Netz ein dreidimensionales Abbild der Kräfte, die auf den künstlichen Daumen einwirken. Die Erfindung verbessert die haptische Wahrnehmung von Roboterfingern erheblich und kommt dem Tastsinn der menschlichen Haut einen wesentlichen Schritt näher.
In einer Publikation im Fachjournal Nature Machine Intelligence stellt ein Team von Wissenschaftler:innen des Max-Planck-Instituts für Intelligente Systeme (MPI-IS) einen robusten, weichen und haptischen Sensor namens „Insight“ vor. Mit Hilfe von Maschinellem Sehen und einem tiefen neuronalen Netzwerk kann der Sensor genau abschätzen, an welcher Stelle Objekte mit ihm in Kontakt kommen und wie groß die einwirkenden Kräfte sind. Das Forschungsprojekt ist ein wichtiger Schritt hin zu Robotern, die wie Menschen und Tiere ihre Umgebung ertasten können. Wie sein natürliches Vorbild ist der Sensor sehr empfindlich, robust und präzise.
Der einem Daumen nachempfundene Sensor besteht aus einer weichen Hülle, die ein leichtes, steifes Skelett in sich einschließt. Dieses Skelett hält die Struktur aufrecht, ähnlich wie Knochen das weiche Gewebe eines Fingers stabilisieren. Die Hülle besteht aus einem Elastomer, das mit dunklen, aber reflektierenden Aluminiumflocken angemischt wurde. Dadurch bekommt die Hülle eine gräuliche Farbe und ist undurchsichtig, so dass kein Licht von außen eindringen kann. Im Inneren dieser fingergroßen Kapsel ist eine winzige 160-Grad-Fischaugenkamera eingebaut. Sie nimmt bunte Lichtmuster auf, die von einem Ring aus LEDs erzeugt werden.
Wenn ein oder mehrere Objekte die Sensorhülle berühren, ändert sich das Farbmuster im Inneren des Sensors. Die Kamera nimmt mehrmals pro Sekunde Bilder auf und füttert mit diesen Daten ein tiefes neuronales Netz. Dem Algorithmus entgeht nichts: in jedem Pixel erkennt er selbst kleinste Veränderung des Lichts. Innerhalb eines Sekundenbruchteils kann das trainierte Modell herausfinden, wo genau ein Objekt den „Finger“ berührt, wie stark die Kräfte sind und in welche Richtung sie wirken. Das Modell leitet daraus das ab, was Wissenschaftler:innen eine force map nennen: ein dreidimensionales Abbild der Kräfte, die auf den künstlichen Daumen einwirken.
Abbildung 1 veranschaulicht den Sensor, das erzeugte bunte Kamerabild und die Berechnung des tiefen neuronalen Netzes: wo genau fand eine Berührung statt, mit welcher Kraft und in welche Richtung über die Oberfläche hinweg fand die Berührung statt. Auch ein Video veranschaulicht die Funktionsweise des Sensors.

„Unser Sensor zeigt eine hervorragende Leistung dank des innovativen mechanischen Designs der Hülle, des maßgeschneiderten Bildgebungssystems im Inneren, der automatischen Datenerfassung und dank modernster Deep Learning Methoden“, sagt Georg Martius, Forschungsgruppenleiter am MPI-IS. Dort leitet er die Autonomous Learning Group. Sein Doktorand Huanbo Sun ergänzt: „Unsere einzigartige Hybridstruktur aus einer weichen Schale, die ein steifes Skelett umschließt, sorgt für hohe Empfindlichkeit und Robustheit. Unsere Kamera kann selbst die kleinsten Verformungen der Oberfläche mit einem einzigen Bild erkennen.“ Tatsächlich stellten die Forscher beim Testen des Sensors fest, dass er empfindlich genug ist, um seine eigene Orientierung im Verhältnis zur Schwerkraft zu spüren.
Das dritte Mitglied des Teams ist Katherine J. Kuchenbecker, Direktorin der Abteilung für Haptische Intelligenz am MPI-IS. Sie bestätigt, dass der neue Sensor nützlich sein wird: „Bisherige weiche haptische Sensoren hatten nur einen kleinen Bereich, in dem sie Dinge erfassen konnten. Sie waren empfindlich und schwierig herzustellen und konnten oft keine Kräfte spüren, die parallel zur Haut verlaufen. Das aber ist für einen Roboter, der ein Glas Wasser hält oder auf einem Tisch eine Münze verschiebt, unerlässlich.“
Doch wie kann ein Sensor lernen, was ihn berührt? Huanbo Sun entwarf einen Versuchsaufbau, um Trainingsdaten zu sammeln. Diese Daten benötigt das maschinelle Lernverfahren, um die Korrelation zwischen der Veränderung der Bildpixel und den angewandten Kräften zu verstehen. Ein Stab stupst den Sensor überall auf seiner Oberfläche, der Computer wiederum zeichnet die Krafteinwirkung zusammen mit dem Kamerabild im Inneren des Sensors auf. Auf diese Weise erzeugten die Forscher etwa 200.000 Messungen. Es dauerte fast drei Wochen, um die Daten zu sammeln und einen weiteren Tag, um den Deep Learning Algorithmus zu trainieren. Der Daumen überstand dieses lange Experiment mit vielen verschiedenen Krafteinwirkungen – ein Beleg für die Robustheit des mechanischen Designs von Insight.
Eine weitere Besonderheit des daumenförmigen Sensors ist, dass es einen Bereich mit einer dünneren Elastomerschicht gibt, die einem Fingernagel nachempfunden ist. Dieses Grübchen ist so konzipiert, dass es selbst kleinste Kräfte und verschiedene Objektformen erkennen kann. Für diese sehr empfindliche Zone wählten die Wissenschaftler:innen eine Elastomerdicke von 1,2 mm statt der 4 mm, die sie ansonsten für den Fingersensor verwendeten.
„Das Hard- und Softwaredesign, das wir in unserer Arbeit vorstellen, lässt sich auf eine Vielzahl von Anwendungsfällen mit unterschiedlichen Formen und Präzisionsanforderungen übertragen. Die Programmierung des Deep Learning Algorithmus, die Datenerfassung, das Training und was das System daraus ableitet sind allgemeingültig und können helfen, viele andere Sensoren zu entwickeln“, schließt Huanbo Sun ab.
-
B2B Communications for Tech Start-ups
Effektive externe Kommunikation ist ein entscheidender Erfolgsfaktor für jedes Unternehmen. Start-ups stehen vor allem in der Anfangsphase vor der Herausforderung, den Bekanntheitsgrad zu steigern und eine erfolgreiche B2B-Kommunikation aufzubauen. Die Entwicklung und Umsetzung einer effektiven Kommunikationsstrategie kann jedoch herausfordernd sein.
Die nächste Ausgabe der Entrepreneurship Series widmet sich daher dem Thema "B2B-Kommunikation für Tech-Start-ups". Erfahrene Kommunikationsexperten geben Einblicke in PR-Grundlagen, B2B-Kommunikation und den effektiven Einsatz von Social Media. Im Anschluss an ihre Vorträge findet eine Fragerunde statt.
Wissenschaftler:innen, Gründer:innen, Studierende und alle, die sich für das Thema interessieren, sind herzlich eingeladen, am Donnerstag, den 24. Februar, 14:00-15:30 Uhr dabei zu sein.
Sprecher:innen
Mark Schiffhauer
Chief Creative Officer, ZEIT Verlagsgruppe & Geschäftsführer, Studio ZXLennart Schmid
Communications Manager, Cyber ValleyJohanna Hailer
Kommunikationsmanagerin, Storymaker GmbHRegistrierung
Bitte hier registrieren. Das Event findet via Zoom und in englischer Sprache statt.
Kontakt
Julia Schmaus – Innovation Manager
E-mail: julia.schmaus@cyber-valley.de
Telefon: +49 7071 601 1546
Mobil: +49 151 6452 0213 -
Lücke in der KI-Ausbildung schließen
Die Universität Stuttgart hat die Artificial Intelligence Software Academy (AISA) im Cyber Valley Verbund gegründet. Sie vereinigt die Bereiche künstliche Intelligenz (KI) mit der Softwareentwicklung, möglichen Anwendungen und ihrer Didaktik. So werden durch AISA Fachkräfte ausgebildet und Forschungsfragen bearbeitet. Das Land Baden-Württemberg verfolgt durch Cyber Valley das Ziel, sowohl akademische als auch wirtschaftliche Spitzenleistungen zu erbringen und hat deshalb die Förderung von AISA in Höhe von zunächst 2,75 Mio. Euro bis Ende 2023 beschlossen.
„Mit ‚AISA‘ erhalten Studierende aus verschiedensten Disziplinen die hervorragende Möglichkeit, sich zur Spitzenkraft im Bereich KI-Software ausbilden zu lassen. Die so gewonnenen Talente können bei der Entwicklung von KI-Software zukunftsorientierte und praxisnahe Lösungen erarbeiten und so die internationale Strahlkraft des Cyber Valley weiter vorantreiben“, sagt Wissenschaftsministerin Theresia Bauer. „Durch die AI Software Academy beschleunigen wir unsere internationale Wettbewerbsfähigkeit in Bezug auf Digitalisierung und künstliche Intelligenz über alle Fachbereiche hinweg, indem wir mit ihr eine bisher unadressierte Lücke in der Ausbildung schließen“, führt Prof. Dr. Wolfram Ressel, Rektor der Universität Stuttgart, fort. „So leistet AISA einen doppelten Beitrag zu unserer Vision der intelligenten Systeme für eine zukunftsfähige Gesellschaft.“ Prof. Dr. Stefan Wagner, Leiter des AISA Direktoriums und Direktor am Institut für Software Engineering der Universität Stuttgart, bestätigt: „Durch unser innovatives Ausbildungs- und Forschungskonzept in Verbindung mit der leistungsfähigen AISA Infrastruktur werden wir künstliche Intelligenz und ihre Nutzung mittels leistungsfähiger Software maßgeblich vorantreiben.“
AISA widmet sich den Herausforderungen in der Wirtschaft und Wissenschaft
Die rapide voranschreitende Digitalisierung und der weitreichende Einsatz von KI beeinflussen unseren Alltag, genauso wie Wirtschaft und Wissenschaft. Daraus resultieren viele neuartige Herausforderungen:
- Wie wird Software für KI-Anwendungen effizient entwickelt?
- Wie macht man KI-Software robust und flexibel?
- Wie wendet man KI-Software in der Wirtschaft und der Wissenschaft an?
- Und wie baut man eine Didaktik auf, die in der Lage ist, Wissen über die Entwicklung, Nutzung und Wartung von KI-Software in viele verschiedene Disziplinen hineinzutragen und so die KI-Expertinnen und -Experten von morgen zu prägen?

In AISA Research werden Projekte aus unterschiedlichsten Bereichen gefördert
In AISA Research werden interdisziplinäre Forschungsvorhaben rund um das Thema KI gefördert. Dabei werden Anwendungen (X), Softwareentwicklung (SE) und deren Didaktik mit KI verknüpft – AI+SE+X. Das AISA Direktorium hat im August 2021 die ersten elf Promotionsprojekte für AISA Research ausgewählt. In den geförderten Projekten zeigt sich die Integration der verschiedenen Bereiche: Es kooperieren Forschende aus der Architektur, Biologie, Chemie, Didaktik, Informatik, dem Maschinenbau und den Umweltingenieurwissenschaften. Projekte mit engem Bezug zu den Exzellenzclustern SimTech und IntCDC sind ebenso vertreten.
Die Promovierenden aus AISA Research bieten mittels AISA Training gezielt Lehrinhalte für Studierende im Master-Bereich und für Cyber Valley Promovierende an. Zusätzlich werden hier Projektarbeiten, Seminare und Hackathons organisiert und betreut. Die Zusatzqualifikation wird durch ein innovatives, mehrstufiges Zertifikatsprogramm strukturiert, das von thematisch fokussierten Microcredentials bis hin zum Diploma of Advanced Studies die passgenaue Abstimmung auf individuelle Qualifizierungsbedarfe ermöglicht.
AISA besteht aus drei Komponenten: Research, Training und Infrastructure

Die Struktur von AISA basiert auf den drei Elementen Forschung (AISA Research), Ausbildung (AISA Training) und einer leistungsfähigen Infrastruktur (AISA Infrastructure), die das AISA Triangle bilden. Sowohl AISA Research als auch AISA Training greifen auf die AISA Infrastructure zurück, die KI-spezifische Hochleistungsrechner bereitstellt. Durch die gute Verfügbarkeit und den einfachen Zugang können Methoden und KI-Pipelines effizient entwickelt werden. Die Leitung von AISA obliegt einem Direktorium bestehend aus Prof. Dr. Stefan Wagner (Vorsitz), Tenure-Track Prof. Dr. Maria Wirzberger, Prof. Dr. Steffen Becker, Prof. Dr. Steffen Staab und Prof. Dr. Felix Fritzen, die wiederum die verschiedenen Disziplinen in AISA repräsentieren.
Über die Förderung durch das Land Baden-Württemberg
AISA ist ein weiteres Projekt aus dem Maßnahmenpaket „Zukunftsland BW – Stärker aus der Krise“. In seinem Rahmen investiert die Landesregierung gezielt in wichtige Zukunftsfelder und stärkt damit nachhaltig den Wirtschafts- und Innovationsstandort. Das Programm legt den Grundstein dafür, dass Baden-Württemberg stärker aus der Coronakrise hervorgehen kann.
Weiterführende Links:
-
Cyber Valley Start-up Incubation Program
Inhalt
Ihr braucht kein Team, keine Vorkenntnisse und kein Gründungsprojekt. Alle Werkzeuge, die ihr für eine erfolgreiche Gründung benötigt, werden euch zur Verfügung gestellt. Gemeinsam mit erfahrenen Start-up Coaches erhaltet ihr Einblicke in Themen wie Team Building, Marktanalyse, Proto- und Pretotyping, Businessmodelle und Start-up Pitches. Am Ende bekommt ihr die Chance, euer Start-up Projekt vor einer hochklassigen Jury zu präsentieren und ihr könnt wertvolle Preise gewinnen.
Zielgruppe
Der Inkubator richtet sich an alle Wissenschaftler:innen aus dem Cyber Valley Ökosystem – und darüber hinaus. Doktorand:innen der International Max Planck Research School for Intelligent Systems (IMPRS-IS) erhalten darüber hinaus 3 Credit Points, wenn sie den Kurs erfolgreich absolvieren.
Ablauf und Termine
Der Inkubator ist als sechswöchiges Programm geplant mit jeweils einem Vor-Ort-Workshop pro Woche (10:00–18:00). Die einzelnen Termine werden abwechselnd in Stuttgart und Tübingen stattfinden. Es wird einen Shuttlebus für Teilnehmer:innen des jeweils anderen Standortes geben. Sollte die Pandemie Vor-Ort-Veranstaltungen nicht erlauben, wird die Veranstaltung virtuell stattfinden. Die Termine sind:
- Freitag, 1. April 2022
- Freitag, 8. April 2022
- Freitag, 22. April 2022
- Freitag, 29. April 2022
- Freitag, 6. Mai 2022
- Freitag, 13. Mai 2022 (finales Pitch Event)
Bewerbung
Um sich für das Cyber Valley Start-up Incubation Program zu bewerben, wird ein Lebenslauf und ein Motivationsschreiben benötigt. Aus dem Motivationsschreiben (ca. eine Seite) soll hervorgehen, warum die Bewerber:innen sich für das Programm interessieren und welches Problem aus ihrem (Forschungs-)Alltag sie mit einem Start-up gerne lösen möchten. Doktorand:innen benötigen außerdem eine schriftliche Erlaubnis ihrer Doktormutter oder ihres Doktorvaters, dass sie an den sechs Terminen teilnehmen dürfen (eine E-Mail genügt).
Nur noch wenige Plätze verfügbar. Bitte sendet euren Lebenslauf, euer Motivationsschreiben und die schriftliche Erlaubnis eurer Doktormutter bzw. eures Doktorvaters an tobias.duerr@cyber-valley.de.
Sprache
Das Programm wird in englischer Sprache angeboten.
Fragen?
Wendet euch gerne an Tobias Dürr, wenn ihr Fragen habt.
-
Nachwuchs für die künstliche Intelligenz
Wenn Prof. Dr. Matthias Hein über seine Studierenden spricht, fangen seine Augen an zu leuchten. „Für mich persönlich ist es immer ein sehr befriedigendes Gefühl, wenn man jungen Menschen etwas beibringen kann“, meint der Koordinator des internationalen Masterstudiengangs Maschinelles Lernen an der Universität Tübingen. Zusammen mit Kolleg:innen hat er den Studiengang aus der Taufe gehoben und freut sich aktuell über die ersten Abgänger:innen. Sie sind geprägt in einem Umfeld, in dem auch ethische und rechtliche Fragen rund um das Thema künstliche Intelligenz (KI) eine wichtige Rolle spielen. Ihr Wissen tragen sie weiter und stärken so den Transfer zwischen Wissenschaft und Wirtschaft – und die Weiterentwicklung des Cyber Valley Ökosystems.
Matthias Hein, Professor für maschinelles Lernen an der Universität Tübingen, blickt mit Spannung auf die nächsten Schritte der Absolvent:innen. Einige schauen sich gerade nach Promotionsstellen um, viele bleiben dabei am Standort, andere wiederum gehen in die Wirtschaft. Für den Professor unterstreicht das die Bedeutung der intensiven Ausbildung im Master-Studiengang: „Gute Leute auszubilden ist eigentlich die wichtigste Komponente, wie wir einen Transfer zwischen Wissenschaft und Gesellschaft sicherstellen können. Mit den Kenntnissen aus ihrem Studium können sie jetzt in die Industrie gehen und ihr Wissen so anwenden, wie sie es hier gelernt haben.“ Und damit die Ausbildung im Studiengang auch wirklich exzellent ist, hat dieser ein sehr spezielles Curriculum, das den Studierenden viele Möglichkeiten bietet.
Studienplan nach dem Baukastenprinzip
„In unserem Master-Studiengang sind die Studierenden sehr frei, in welche Richtung sie sich spezialisieren wollen“, erklärt Hein. Daher sieht der Studienplan nur wenige Pflichtfächer vor. „Es gibt natürlich eine breite Einführung in die Grundlagen. Aber dann kann man sich sein Studium so gestalten, wie man möchte – und man ist im Prinzip frei, eigene Themen einzubringen.“ So können die Studierenden beispielsweise auch Vorlesungen aus komplett anderen Fachbereichen wie Ethik, Philosophie, Jura oder BWL belegen.
So möchten Hein und seine Kolleg:innen zum einen dem Wesen der KI als Querschnittsdisziplin Rechnung tragen, die mittlerweile in einer ganzen Reihe unterschiedlicher Forschungsrichtungen zum Einsatz kommt. Zum anderen fördert es die intensive und vor allem auch kritische Auseinandersetzung mit KI, ihren Grenzen und den gesellschaftlichen Herausforderungen.
Diese offene Ausrichtung macht den ersten und bislang einzigen Universitäts-Studiengang in Deutschland im Bereich maschinelles Lernen einzigartig. Hinzu kommt eine breite, internationale Ausrichtung des englischsprachigen Studiums. So soll der Austausch mit Forscher:innen aus anderen Ländern und Kulturen gefördert werden.
Reden – miteinander statt übereinander
Den Austausch mit der Gesellschaft versuchen die Forschenden auch auf breiter Ebene engagiert anzugehen, gerade auch vor dem Hintergrund der Ethik-Debatten, die immer wieder rund um das Thema entstehen. Für Matthias Hein sind das wirklich wichtige Aktivitäten, denn manchmal sei einfach noch nicht ganz klar, wie Dinge in der Forschungsrealität abliefen und was es mit KI wirklich auf sich habe. „Durch direkte Gespräche, lassen sich oft viele Fragen schnell klären“, so der Professor. Entsprechend positiv sieht er auch die Unterstützung durch das Cyber Valley Public Engagement Team, das dezidiert die Vermittlung zwischen der Öffentlichkeit und den Forschenden im Bereich KI unterstützt.
„Es ist eine super Sache, dass Cyber Valley hier so aktiv ist. Andere Standorte sind in der Ethik-Debatte teilweise noch am Anfang – wir sind dadurch zumindest schon mittendrin“, stellt Hein fest. Besonders gut beurteilen kann Hein das auch aus seiner eigenen Forschung heraus. Seine Arbeit deckt unter anderem zwei Aspekte ab, die oft im Zentrum ethischer Auseinandersetzungen rund um KI stehen: die Robustheit und die Erklärbarkeit der Entscheidungen dieser Systeme.
Zuverlässigkeit und Fairness als Schlüssel zur Akzeptanz
In einem neuen Forschungsprojekt geht Hein jetzt im Medizinbereich den Fragen nach, wie die Zuverlässigkeit und Genauigkeit von KI-Anwendungen bei der Diagnose von Krankheiten verbessert, also wie diese Systeme robuster gemacht werden können. Das Projekt wird über mehr als fünf Jahre mit insgesamt fünf Millionen Euro von der Carl-Zeiss-Stiftung gefördert. „Es geht uns darum, ein Regelwerk zu kreieren, das sicherstellt, dass KI-Systeme in der Praxis dann so funktionieren, wie wir das von ihnen erwarten“, formuliert Hein das Ziel. Denn gerade in sicherheitskritischen Bereichen wie der Medizin sind die Herausforderungen und die Relevanz für maschinelles Lernen besonders hoch. Nur so kann langfristig die Akzeptanz für den Einsatz solcher Systeme auf breiter gesellschaftlicher Basis sichergestellt werden.
Einen ebenso spannenden gesellschaftlichen Austausch stellt die Auseinandersetzung mit dem Thema Fairness von KI dar. Denn auch vermeintlich neutrale Systeme können unfaire Entscheidungen treffen – nämlich zum Beispiel dann, wenn sie mit einseitigen und unausgewogenen Daten trainiert wurden. Dabei stellt sich aber immer auch die grundlegende Frage, was eine Gesellschaft für fair hält – sozusagen als gemeinsamen Nenner. „Es ist wichtig, dass wir ein Bewusstsein dafür schaffen, dass bestimmte Fragen gesellschaftlich diskutiert und evaluiert werden müssen. Denn es kann nicht Aufgabe der Entwickelnden von KI-Systemen sein, zu definieren, was fair ist – das ist eine gesellschaftliche Frage“, unterstreicht Matthias Hein die Bedeutung eines intensiven gesellschaftlichen Austauschs.
Der Mensch macht’s
Cyber Valley mit seinen Standorten in Stuttgart und Tübingen bringt für Hein beste Voraussetzungen mit, um solche Debatten zu führen. „Cyber Valley hat sehr gute Wissenschaftlerinnen und Wissenschaftler hierher gebracht, die ihrerseits sehr gute Leute anziehen“, beschreibt der Professor die positive Dynamik und die besondere Strahlkraft von Cyber Valley weit über die Landesgrenzen hinaus.
Auch für Matthias Hein selbst, der 2018 aus Saarbrücken an die Universität Tübingen gewechselt ist und eine von Cyber Valley und Bosch eingerichtete Stiftungsprofessur übernommen hat, war das Umfeld verlockend. Mit dem Master-Studiengang maschinelles Lernen arbeitet er nun mit daran, die Vielfalt und Qualität des Standorts weiter zu stärken.
Immer wieder hinterfragen
Dementsprechend ist Matthias Hein auch sehr optimistisch, wenn man ihn nach der Zukunft von Cyber Valley und dem KI-Ökosystemim Herzen Baden-Württembergs fragt. „Wir sind hier auf einem sehr guten Weg“, so Hein, der sich sicher ist, dass der Standort weiter auf sehr hohem Niveau wachsen kann. Wichtig sei dabei aber, immer den kontinuierlichen Austausch und den Transfer aus der Forschung in die Gesellschaft und die Wirtschaft im Blick zu behalten. Und vor allem die Impulse aus diesen Bereichen aufzusaugen.
So wie das Hein auch in der Nachwuchsarbeit macht: „Es ist spannend, wenn man von Studierenden herausgefordert wird. Wenn Überlegungen in Frage gestellt werden und man die Dinge auch selbst immer wieder hinterfragen und gut begründen muss.“ Und das bringt nicht nur den Nachwuchs voran. Das hilft auch dabei, KI und maschinelles Lernen mit gemeinsamer Kraft und kritischem Blick in der Gesellschaft zu verankern.
-
Scientific Symposium
Schedule (CET)
Wednesday January 12 12:45-1:00 pm Opening remarks 1:00-2:30 pm Presentations | Part One 2:30-3:00 pm Break 3:00-4:30 pm Presentations | Part Two Thursday January 13 8:45-9:00 am Opening remarks 9:00-10:30 am Presentations | Part Three 10:30-11:00 am Break 11:00 am – 12:30 pm Presentations | Part Four Presentations:
Towards Machines that See the World like Humans
Wieland Brendel (University of Tübingen, Germany)
Talk: Wednesday, January 12, 2021 – 1:00-1:30 pm
Abstract >
In the past few years, deep neural networks have surpassed human performance on a range of complex cognitive tasks. However, unlike humans, these models can be derailed by almost imperceptible perturbations, often fail to generalize beyond the training data and require large amounts of data to learn novel tasks. A core reason for this behavior is shortcut learning, i.e. the tendency of neural networks to pick up statistical signatures sufficient to solve a given task instead of learning the underlying causal structures and mechanisms in the data. My research ties together adversarial machine learning, disentanglement, interpretability, self-supervised learning, and theoretical approaches like nonlinear Independent Component Analysis to develop theoretically grounded yet empirically successful visual representation learning techniques that can uncover the underlying structure of our visual world and close the gap between human and machine vision.
An Algorithmic Safety View of Learning in Human-centered Domains
Shalmali Joshi (Harvard University, Cambridge, USA)
Talk: Wednesday, January 12, 2021 – 1:30-2:00 pm
Abstract >
Machine Learning advances have revolutionized many domains such as machine translation, complex game playing, and scientific discovery. On the other hand, ML has only enjoyed modest successes in human-centered applications. To improve the utility, reliability, and robustness of Machine Learning (ML) models in human-centered domains, we need to address several foundational challenges. In this talk, I will demonstrate how an algorithmic-safety perspective can motivate specific technical challenges for learning in human-centered domains such as healthcare. Specifically, I will discuss the need to improve the utility of ML-robustness, explainability with an emphasis on decision-making, and post-hoc algorithmic safety to prevent harm. I will discuss my contributions on i) novel methods to improve causal robustness of ML methods designed for practical generative settings, ii) aiding safe decision-making in non-IID settings using time-series explainability intended to address clinicians’ requirements, and iii) novel learning algorithms to optimize for post-deployment safety in sequential decision-making settings. I will conclude with an overview of my future research vision on novel safety-based objectives for explainability in ML, expanding ML-based solutions to general and practical generative settings, and outlining novel ways of validating ML models targeting safety-based objectives.
On Inferential Challenges in Modern Machine Learning
Jiaxin Shi (Microsoft Research New England, Cambridge, USA)
Talk: Wednesday, January 13, 2021 – 2:00-2:30 pm
Abstract >
Machine learning (ML) can be viewed as solving two types of inferential tasks: inferring models from data and inferring knowledge from models. Central to this perspective is the development of fast, accurate inference methods for model parameters and latent variables. In this talk, I will present my work on addressing inferential challenges in modern ML which are characterized by enhanced model complexity and massive datasets that demand algorithms at scale. I will focus on 1) theory and methods of score estimation, an emerging tool for dealing with intractable probability densities in today's highly expressive ML models, and 2) orthogonal inducing points, an inferential idea that advanced the state-of-the-art of scalable uncertainty models in ML. Finally, I will discuss future directions that connect these ideas to generative modeling, continual learning, and how they could help us understand deep learning.
Computer Vision for Global-scale Biodiversity Monitoring
Sara Beery (California Institute of Technology, Pasadena, USA)
Talk: Wednesday, January 12, 2021 – 3:00-3:30 pm
Abstract >
We require a real-time, modular earth observation system that unites efforts across research groups in order to provide the vital information necessary for global-scale impact in sustainability and conservation in the face of climate change. The development of such systems requires collaborative, interdisciplinary approaches that translate diverse sources of raw information into accessible scientific insight. For example, we need to monitor species in real time and in greater detail to quickly understand which conservation efforts are most effective and take corrective action. Current ecological monitoring systems generate data far faster than researchers can analyze it, making scaling up impossible without automated data processing. However, ecological data collected in the field presents a number of challenges that current methods, like deep learning, are not designed to tackle. These include strong spatiotemporal correlations, imperfect data quality, fine-grained categories, and long-tailed distributions. My work seeks to overcome these challenges, and includes methods which can learn from imperfect data, systematic frameworks for measuring and overcoming performance drops due to domain shift, and the deployment of efficient human-AI systems that have made significant real-world conservation impact. My future research agenda will expand upon the strong foundation built by my past and current research. It will seek to make effective use of all available modalities of data, incorporate expert knowledge systematically, and ensure these systems are equitable and ethical – all fundamental and unresolved challenges for CV&ML.
Open-World Learning for Biomedicine
Maria Brbic (Stanford University, Stanford, USA)
Talk: Wednesday, January 13, 2021 – 3:30-4:00 pm
Abstract >
Biomedical data poses multiple hard challenges that break conventional machine learning assumptions. In this talk, I will highlight the need to move beyond our prevalent machine learning paradigms and methods to enable them to drive novel biomedical discoveries. I will focus on open-world deep learning methods that generalize to new scenarios never seen during training and demonstrate the impact they have in single-cell genomics. I will first present a method that transfers knowledge across heterogeneous datasets generated under different distributions, and then describe the paradigm needed to discover previously unobserved phenomena. I will discuss the biological findings enabled by these methods and the conceptual shift they bring in annotating comprehensive single-cell atlas datasets. Altogether, my work demonstrates that generalization to never-before-seen scenarios is not only possible, but it is a necessary component in developing next-generation methods that can reveal new scientific insights.
Social Robots for Health and Education
Patrícia Alves-Oliveira (University of Washington, Seattle, USA)
Talk: Wednesday, January 12, 2021 – 4:00-4:30 pm
Abstract >
I build innovative social robots that address important challenges in health care and education. A unifying challenge that I address in my work is that most of the existing resources that treat complex health and learning problems are developed for professionals. My vision is to democratize health care and education by using social robots to break barriers of access to these critical domains. Towards this, I designed, developed, fabricated, and deployed robots capable of reciprocal interactions with humans to be used as valuable sources of knowledge and assistance that empower people to make decisions about their mental health, social-emotional learning, and creativity. My work probes the intersection of the fields of Human-Robot Interaction, Human-Centered Design, and Artificial Intelligence as essential building blocks for creating social robots that can empower human health and education.
Intelligent Soft Systems – How Fundamental Physical Principles Enable Function
Philipp Rothemund (Max Planck Institute for Intelligent Systems, Stuttgart, Germany)
Talk: Thuradsy, January 13, 2020 – 9:00-9:30 am
Abstract >
Functional soft materials promise to revolutionize robotics hardware by providing entirely new functions and by allowing robots to perform better than traditional robots made from materials such as metals and electromagnetic motors. Over the last decade a large variety of intelligent systems based on functional soft materials have been successfully demonstrated. However, only the surface of the capabilities of these new types of materials has been skimmed, because the fundamental materials behavior, from which they derive their functionality, is often not sufficiently understood.
In this talk, I discuss fundamental physical principles of soft materials, which can enable function in high-performing soft devices. First, I describe how snap-through instabilities in elastomeric structures can be exploited for electronics-free control of robots. Then, I discuss how the electromechanical coupling between electric fields and soft structures enables electroactive devices and artificial muscles. Finally, I outline nonlinear and thermomechanical effects, which have the potential to serve as the basis for the next generation of intelligent soft systems.
Advanced Multimodal Locomotion and Multifunctionality of Soft-bodied Millirobots
Wenqi Hu (Max Planck Institute for Intelligent Systems, Stuttgart, Germany)
Talk: Thursday, January 13, 2020 – 9:30-10:00 am
Abstract >
Large individually-controlled degrees of freedom (DOF) in animal epidermises enable the animals to dynamically and dexterously interact with their natural environment for diverse functions. This capability still holds at small length scales: flatworms, starfish larvae, corals, comb jellyfishes, and millipedes utilize their numerous individually-controlled cilia, tube feet, or tiny legs for highly adaptable locomotion and multiple functions, such as nutrient transportation, predation, and bio-mixing. Despite their significant future potential applications and numerous recent advances, current miniature (centi-/millimeter) robots still do not have similar tiny cilia, feet, or legs in their epidermises to dynamically and dexterously interact with their operation environment, which severely limits their locomotion capabilities and functionalities.
The presentation will first walk through my previous projects of using physical intelligence, such as soft design, flow structure interaction, and metachronal coordination, to enhance miniature robots' locomotion capability and functions. Then, I will briefly discuss how I support these investigations on robotics by innovating on micro-fabrication and novel materials. At last, I will propose a new methodology to address the prementioned scientific challenge directly. Such an approach would immediately augment the functional interaction of various miniature robots with their surrounding environments, leading to disruptive locomotion and manipulation capabilities for various future applications.
Structured Learning – Encoding Structure from Physics, Algorithms, and Geometry into Machine Learning for Robotics and Computer Vision
Rico Jonschkowski (Google Brain, Mountain View, USA)
Talk: Thursday, January 13, 2020 – 10:00-10:30 am
Abstract >
This talk focuses on the interaction of structural assumptions and machine learning. While modern machine learning (aka deep learning) is able to leverage large amounts of data and computation to achieve important results, I believe that the recent shift of the community towards ever more general learning approaches is flawed. The progress of deep learning so far has relied heavily on advances in computation, data collection, and software libraries. But as such improvements are plateauing, future progress in AI requires us to reevaluate the role of structure in learning and to tightly integrate both for better data efficiency, generalization, and explainability. In this talk, I will present how structure from physics, algorithms, and geometry can be encoded in learning approaches to robotics and computer vision and why we need a better fundamental understanding of the interaction of structure, learning, and optimization.
Towards Democratic Learning and Collective Intelligence
Krikamol Muandet (Max Planck Institute for Intelligent Systems, Tübingen, Germany)
Talk: Thursday, January 13, 2020 – 11:00-11:30 am
Abstract >
An ability to generalize to unseen environments is of paramount importance in machine learning. In order to equip artificially intelligent systems with such capability, it is necessary to deal with various forms of distributional shifts and to distinguish between spurious correlations and genuine ones in the observed data. To this end, the first part of this talk will be about the Hilbert space embedding of distributions, or kernel mean embedding (KME) for short, which is a nonparametric kernel-based framework to represent probability distributions and model changes thereof. In particular, I will focus on how this framework can help improve the credibility of algorithmic decision making based on observational data by enabling us to reason about higher-order causal effects of policy interventions as well as by removing the effect of unobserved confounders through the use of an instrumental variable (IV) and a proxy variable. In the second part of this talk, we will take a sober look at the foundation of learning and generalization. In order to build intelligent systems that can truly generalize to the real world, we must take a step back and question the traditional definition of generalization and standard procedures in machine learning. Since society is made up of a set of diverse individuals, demographic groups, and institutions, learning and deploying algorithmic models across heterogeneous environments face a set of various trade-offs. I will argue that in such heterogeneous environments, creating machine learning frameworks that allow for real-world generalization is reminiscent of designing algorithms that respect the democratic principle.
Diversity and Inequality in Social Networks
Ana-Andreea Stoica (Columbia University, New York, USA)
Talk: Thursday, January 13, 2020 – 11:30 am – 12:00 pm
Abstract >
Online social networks often mirror inequality in real-world networks, from historical prejudice, economic or social factors. Such disparities are often picked up and amplified by algorithms that leverage social data for the purpose of providing recommendations, diffusing information, or forming groups. In this talk, I discuss an overview of my research involving explanations for algorithmic bias in social networks, briefly describing my work in information diffusion, grouping, and general definitions of inequality. Using network models that reproduce inequality seen in online networks, we'll characterize the relationship between pre-existing bias and algorithms in creating inequality, discussing different algorithmic solutions for mitigating bias.
Towards Principled Algorithmic Support of Human Decision-Making
Ivan Stelmakh (Carnegie Mellon University, Pittsburgh, USA)
Talk: Thursday, January 13, 2020 – 12:00-12:30 pm
Abstract >
Many important applications such as hiring, healthcare, and scientific peer review rely on human decision-making. Recently, the scale of many of these applications has increased dramatically which is both an opportunity and a challenge. On the one hand, the large amount of data generated in these applications opens up an opportunity to take a novel data-centric perspective on the classical problems of human decision-making. On the other hand, the large scale makes it hard or even impossible for humans to do all the work manually; hence, there is a challenge of developing principled algorithmic tools to support human decision-makers. In this talk, I will discuss my work on exploring the opportunities and addressing the challenges in the context of scientific peer review. In that, I will talk about empirical and theoretical work that has impacted major Computer Science conferences such as NeurIPS and ICML. I will then outline ideas for future work.
-
Building and Habitats object Model
Ein Schlüsselaspekt, der diskutiert werden wird, ist die Möglichkeit, mehrere analytische Darstellungen eines beliebigen Entwurfs zu erstellen und miteinander zu verknüpfen – was die Entwurfskoordinierung erleichtert, wo dies erforderlich ist –, aber auch Flexibilität und Anpassungsfähigkeit bietet, was bei komplexen Entwurfsabläufen unerlässlich ist.
Das BHoM wurde zudem von Grund auf mit Blick auf eine breite Beteiligung und eine vielfältige Mitautorenschaft entwickelt. Diese Arbeitsweise, sowohl bei der Erstellung als auch bei der Nutzung der Werkzeuge, ermöglicht eine leistungsstarke, transdisziplinäre, leistungsorientierte Planung in großem Maßstab.
Es werden Beispiele für Anwendungen in den Bereichen Strukturanalyse, Lebenszyklusanalyse und Umweltdesign gezeigt.

Dr. Al Fisher – Technischer Direktor und Leiter der rechnergestützten Entwicklung bei Buro Happold
Al Fisher leitet die Computerentwicklung von Buro Happold weltweit. Er hat einen Master und einen Doktortitel in Bau- und Architekturingenieurwesen von der University of Bath und kam 2007 zu Buro Happold. Seitdem hat er sich auf leistungsorientierte Planung und Optimierung konzentriert und diese Prinzipien bei Projekten wie dem Louvre Abu Dhabi und dem Umbau des Londoner Olympiastadions angewandt.
Die Veranstaltung findet digital über WebEx und in englischer Sprache statt. Um an der Veranstaltung teilzunehmen, klicken Sie hier.
Über IntCDC
Die Vision des Exzellenzclusters Integrative Computational Design and Construction for Architecture (IntCDC) der Universität Stuttgart ist es, das volle Potenzial digitaler Technologien zu nutzen, um Design, Fertigung und Konstruktion auf der Grundlage von Integration und Interdisziplinarität neu zu denken. Ziel ist es, bahnbrechende Innovationen im Bausektor zu ermöglichen, wie sie nur durch hochintegrative Grundlagenforschung in einem interdisziplinären, groß angelegten Forschungsvorhaben entstehen können.
Das Cluster will die methodischen Grundlagen für ein tiefgreifendes Umdenken im Planungs- und Bauprozess und den damit verbundenen Bausystemen schaffen, indem es einen integrativen rechnerischen Ansatz verfolgt, der auf interdisziplinärer Forschung aus den Bereichen Architektur, Bauingenieurwesen, Bauphysik, Ingenieurgeodäsie, Fertigungs- und Systemtechnik, Informatik und Robotik sowie Sozial- und Geisteswissenschaften basiert. Ziel ist es, die international anerkannten Kompetenzen der Universität Stuttgart und des Max-Planck-Instituts für Intelligente Systeme in diesen Bereichen zu bündeln, um den Forschungsauftrag zu erfüllen.
Das IntCDC beherbergt mehr als 120 Forscherinnen und Forscher der Universität Stuttgart und des Max-Planck-Instituts für Intelligente Systeme und wird seit 2019 von der Deutschen Forschungsgemeinschaft (DFG) gefördert.
-
Cyber Valley bei NeurIPS erneut an der Spitze
In Summe werden 50 Beiträge von Cyber Valley Forschenden auf der 35. Conference on Neural Information Processing Systems (NeurIPS) präsentiert. Angesichts der weiterhin anhaltenden COVID-19-Pandemie findet die weltweit führende Konferenz für maschinelles Lernen vom 6. bis zum 12. Dezember erneut online statt.
Die Anzahl der eingereichten Paper bei NeurIPS beläuft sich für 2021 auf 9.112, von denen 2.334 Paper den Review-Prozess erfolgreich durchlaufen haben und akzeptiert wurden. Darunter befinden sich 50 Arbeiten von Cyber Valley Forschenden, die nun im Rahmen der virtuellen Veranstaltung als Poster, Spotlights und Vorträge präsentiert werden. Während die Zahl der Einreichungen sowie der angenommenen Paper im Vergleich zum Vorjahr ähnlich geblieben ist, haben sich die erfolgreich zur Präsentation auf der Konferenz avancierten Beiträge der Forschenden aus dem Cyber Valley Konsortium nahezu verdoppelt.
„Cyber Valley feiert im Dezember sein fünfjähriges Bestehen. Dass auf der NeurIPS von Jahr zu Jahr mehr unserer Arbeiten akzeptiert werden, ist ein messbarer Erfolg für die Weiterentwicklung unseres Ökosystems“, sagte Professor Bernhard Schölkopf, Direktor am Max-Planck-Institut für Intelligente Systeme (MPI-IS) in Tübingen. „Bei einer der weltweit führenden Konferenzen zum maschinellen Lernen so abzuschneiden, zeigt deutlich, dass die Region Stuttgart-Tübingen ein Hotspot für international erstklassige KI-Forschung ist.“
Cyber Valley wurde vor fünf Jahren im Dezember 2016 im Südwesten Deutschlands gegründet und ist Europas führendes Forschungskonsortium auf dem Gebiet der KI. Die Autor:innen der insgesamt 50 auf von der NeurIPS akzeptierten Paper aus dem Cyber Valley Ökosystem lassen sich in 31 Fällen Forschenden der Universität Tübingen zuordnen, in 29 denen des MPI-IS, in neun denen des Bosch-Zentrums für Künstliche Intelligenz (BCAI) und in je einem der Universität Stuttgart sowie des Max-Planck-Instituts für Biologische Kybernetik. Viele der Paper sind dem Zusammenschluss der Forschenden der einzelnen Einrichtungen entsprungen, daher tauchen die Paper in der Aufschlüsselung mehrfach auf. Eine vollständige Liste der Arbeiten, Autor:innen und ihrer Zugehörigkeit ist hier verfügbar.
Cyber Valley ist auch im Jahr 2021 weiter gewachsen und strahlt im Glanz seines fünfjährigen Jubiläums. So ist das Cyber Valley Start-up Network inzwischen 29 Mitglieder stark, die fünfte Bewerbungsrunde des Graduiertenprogramms International Max Planck Research School for Intelligent Systems (IMPRS-IS) abgeschlossen und das Tübinger Center for Rhetorical Science Communication Research on Artificial Intelligence (RHET AI) gegründet worden. Die Universität Stuttgart hat zudem die Artificial Intelligence Software Academy (AISA) gestartet und das European Lab for Learning and Intelligent Systems (ELLIS) hat vier neue Units ins Leben gerufen, darunter eine in Stuttgart.
Über NeurIPS
Die NeurIPS ist neben der International Conference on Machine Learning (ICML) und der International Conference on Learning Representations (ICLR) eine der drei Hauptkonferenzen mit hohem Einfluss auf maschinelles Lernen und KI. Die Konferenz fand 1987 zum ersten Mal statt und ist heute eine mehrstufige interdisziplinäre Jahrestagung, die eingeladene Vorträge, Vorführungen, Symposien sowie mündliche und Posterpräsentationen von Arbeiten umfasst, die erfolgreich aus einem strengen Review-Prozess hervorgehen. Neben der Konferenz gibt es eine Fachausstellung, die sich auf maschinelles Lernen in der Praxis konzentriert, eine Reihe von Tutorien und thematische Workshops, die einen weniger formellen Rahmen für den Gedankenaustausch bieten.